
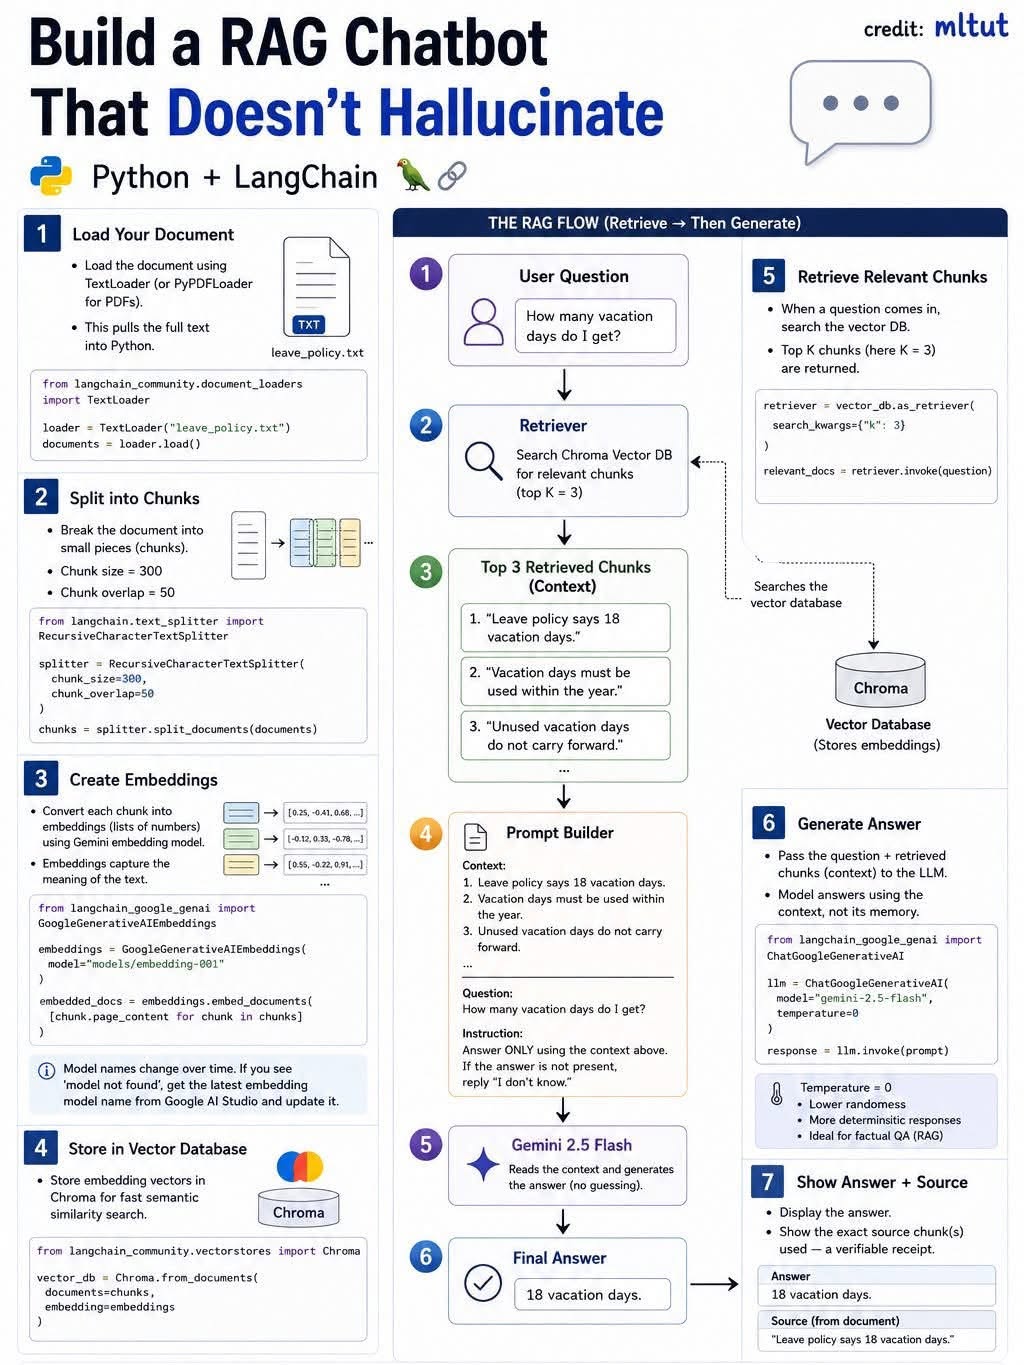
LangChain을 사용하여 구현하는 방법을 설명하고 있습니다.
전문 분야인 IT 시스템 개발 및 데이터 관리 관점에서, RAG 챗봇 구축 과정을 단계별 매뉴얼로 정리해 드립니다.
[RAG 챗봇 구축 매뉴얼: 환각 없는 정보 처리]
RAG의 핵심 원리는 모델이 학습된 메모리에만 의존하는 대신, ”외부 문서에서 정답을 검색(Retrieval)한 후, 그 정보를 바탕으로 답변을 생성(Generate)"하는 '오픈 북(Open Book)' 시험 방식입니다.
1단계: 문서 로드 (Document Loading)
목적: 분석할 원천 데이터를 시스템 내부로 불러옵니다.
방법: TextLoader 또는 PyPDFLoader를 사용하여 텍스트나 PDF 파일을 읽어 들입니다. 로드된 데이터는 텍스트 형태로 Python 객체에 저장됩니다.
2단계: 문서 분할 (Chunking)
목적: 문서 전체를 한꺼번에 처리하기엔 너무 크므로, 검색 효율을 위해 작은 단위(Chunk)로 나눕니다.
핵심 설정:
Chunk Size: 각 조각의 크기(예: 300자).
Chunk Overlap: 조각 간 겹치는 부분(예: 50자). 앞뒤 조각의 맥락이 끊기는 것을 방지합니다.
3단계: 임베딩 생성 (Embeddings)
목적: 텍스트를 AI가 이해할 수 있는 숫자의 벡터(Vector) 형태로 변환합니다. 의미가 비슷한 문장은 벡터 공간에서 서로 가까운 거리에 위치하게 됩니다.
도구: Gemini 임베딩 모델을 사용하여 텍스트의 '의미'를 벡터로 인코딩합니다.
4단계: 벡터 데이터베이스 저장 (Vector Database)
목적: 생성된 벡터들을 효율적으로 검색하기 위해 저장합니다.
도구: Chroma 데이터베이스를 사용하여 벡터화된 문서 조각들을 저장하고, 추후 쿼리 시 의미 기반 검색이 가능하도록 합니다.
5단계: 관련 조각 검색 (Retrieve Relevant Chunks)
목적: 사용자 질문과 가장 관련성이 높은 상위 K개의 문맥(Context)을 데이터베이스에서 찾아냅니다.
설정: K=3으로 설정 시, 유사도가 높은 상위 3개 조각을 가져옵니다.
6단계: 답변 생성 (Generate Answer)
목적: 검색된 문맥을 프롬프트와 함께 LLM에 전달하여 최종 답변을 생성합니다.
핵심 로직:
프롬프트에 "제공된 문맥(Context)만을 사용하여 답변하라"는 지시를 포함합니다.
Temperature = 0으로 설정하여 모델의 창의성을 배제하고, 사실에 기반한 결정론적 답변을 유도합니다.
답변할 수 없는 내용이라면 "모른다"고 답하게 설계합니다.
7단계: 결과 및 출처 확인 (Show Answer + Source)
목적: 답변의 근거를 명확히 하여 신뢰성을 확보합니다.
방법: 답변과 함께 참고한 문서 조각(Source)을 출력하여 사용자가 정보의 출처를 직접 검증할 수 있게 합니다.
[기술적 고려사항 및 요약]
언제 RAG를 사용하는가?
데이터가 방대하거나 문서에 기반한 정확한 답변이 필요할 때.
실시간 업데이트가 필요한 정보(예: 가격, 정책 등)를 다룰 때.
언제 RAG를 사용하지 않는가?
데이터가 매우 작아 프롬프트에 직접 입력 가능한 경우.
창의적인 글쓰기나 추론이 목적일 때.
이 과정은 인증 심사원으로서 ISO/IEC 27001 등 정보보안 관리 시스템을 다룰 때,
방대한 내부 규정이나 보안 정책을 AI가 정확하게 참조하여
답변하도록 만드는 데 매우 효과적인 아키텍처입니다.
특히, 검색된 출처를 명시함으로써 기술적 투명성을 보장할 수 있다는 점이
강점입니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)