
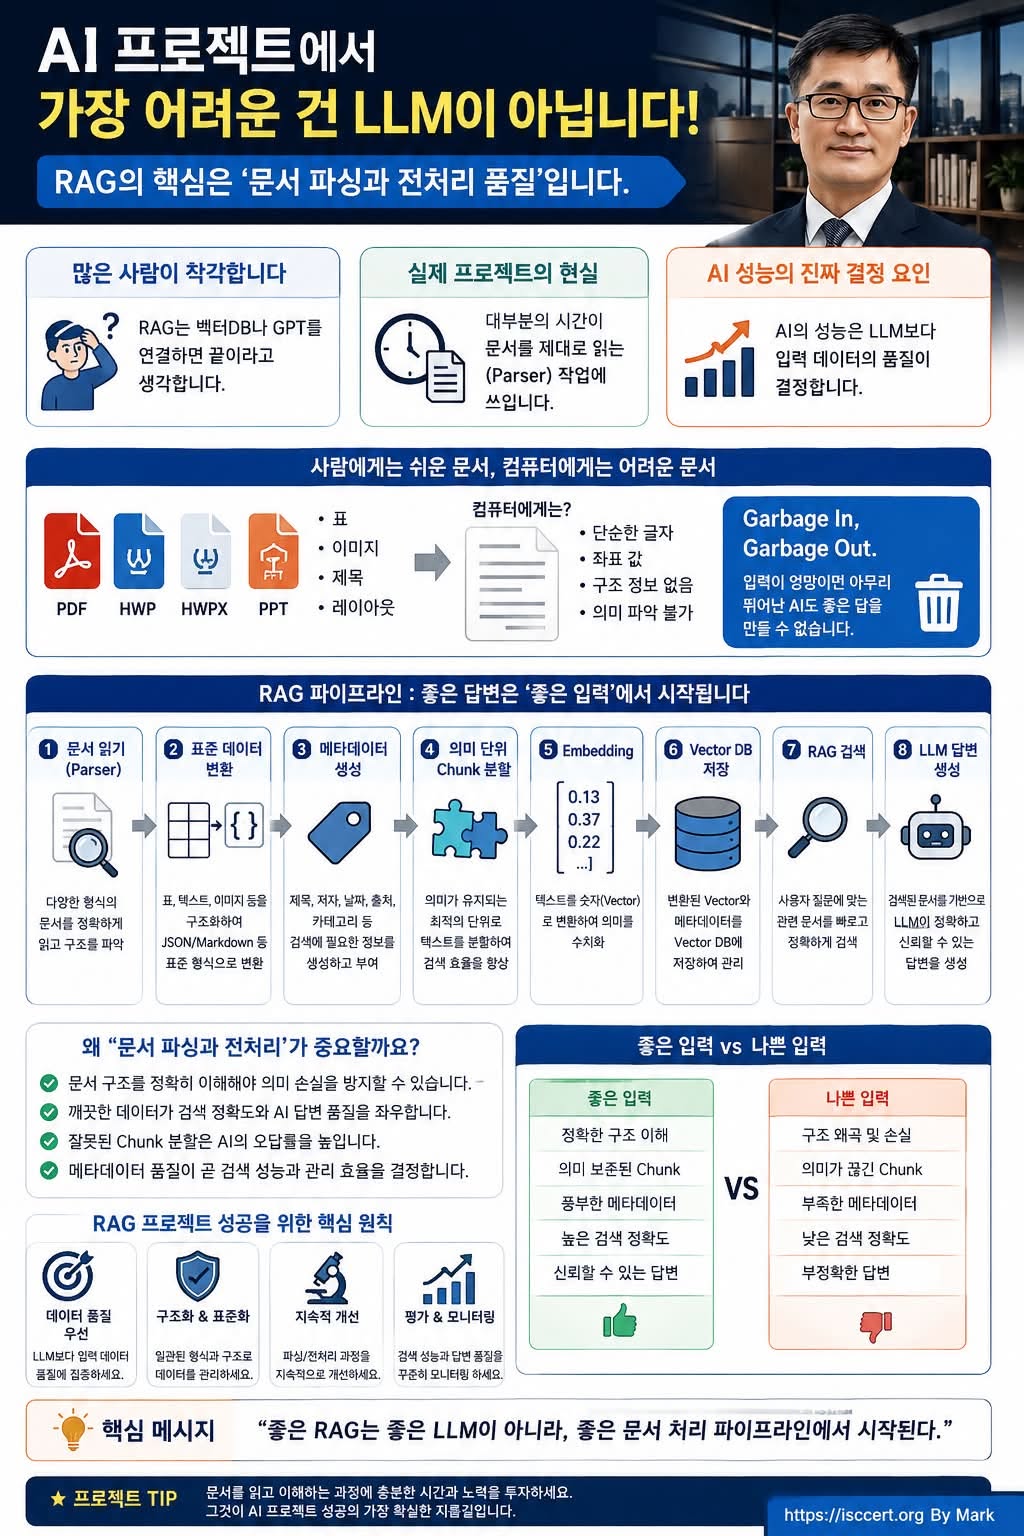
많은 사람들이 RAG(Retrieval-Augmented Generation)를 구축할 때 LLM, Vector DB, Embedding 모델에만 집중합니다.
하지만 실제 프로젝트를 수행해 보면 가장 많은 시간과 노력이 투입되는 곳은 의외로 문서 파싱(Parser)과 전처리(Preprocessing) 단계입니다.
PDF, HWP, HWPX, DOCX, PPT 파일은 사람이 보기에는
표, 이미지, 제목, 문단, 캡션이 잘 정리된 문서입니다. 하지만 컴퓨터는 이를 텍스트, 좌표, 폰트 정보의 집합으로만 인식합니다.
즉, 문서의 구조와 의미를 제대로 이해하지 못하면 AI는 잘못된 정보를 검색하고,
결국 부정확한 답변을 생성하게 됩니다.
Garbage In, Garbage Out
입력 데이터의 품질이 낮으면 아무리 뛰어난 GPT나 Claude, Gemini를 사용하더라도 결과 역시 좋을 수 없습니다.
RAG의 핵심 처리 파이프라인
문서 읽기(Parser)
Markdown / JSON 등 표준 데이터로 변환
메타데이터 생성(제목, 작성자, 날짜, 문서 유형 등)
의미 단위(Chunk) 분할
Embedding 생성
Vector DB 저장
Hybrid Search(BM25 + Vector)
LLM 추론 및 답변 생성
왜 Parser가 가장 중요할까요?
좋은 Parser는 단순히 텍스트만 추출하지 않습니다.
표(Table) 구조 유지
제목과 본문 계층 구조 유지
이미지와 캡션 연결
페이지 정보 보존
문단 흐름 유지
메타데이터 자동 생성
이 과정이 제대로 수행되어야 검색 정확도가 크게 향상되고, LLM은 더 신뢰할 수 있는 답변을 생성할 수 있습니다.
최근 RAG의 트렌드
초기 RAG는 OCR이나 단순 텍스트 추출만 수행했습니다.
최근에는 Vision Language Model(VLM) 을 활용하여 문서를 사람처럼 이해하는 방향으로 발전하고 있습니다.
대표적으로 GPT-4o, Claude, Gemini 등의 멀티모달 모델은
표의 의미
차트와 그래프
레이아웃
문서 구조
이미지 설명
까지 함께 이해하여 기존 OCR 기반 Parser보다 훨씬 높은 정확도를 제공합니다.
AI 프로젝트의 성공 공식
많은 기업은 “어떤 LLM을 사용할 것인가?“를 고민합니다.
하지만 실무에서는 그보다 더 중요한 질문이 있습니다.
“우리 문서를 AI가 제대로 이해할 수 있도록 전처리했는가?”
AI 성능은 단순히 모델의 크기로 결정되지 않습니다.
문서 품질
Parser 성능
Chunk 전략
메타데이터 품질
검색(Search) 정확도
이 다섯 요소가 함께 갖춰질 때 비로소 신뢰할 수 있는 RAG 시스템이 완성됩니다.
결론은 명확합니다.
좋은 RAG는 좋은 LLM에서 시작되는 것이 아니라, 좋은 문서 처리 파이프라인에서 시작됩니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)