
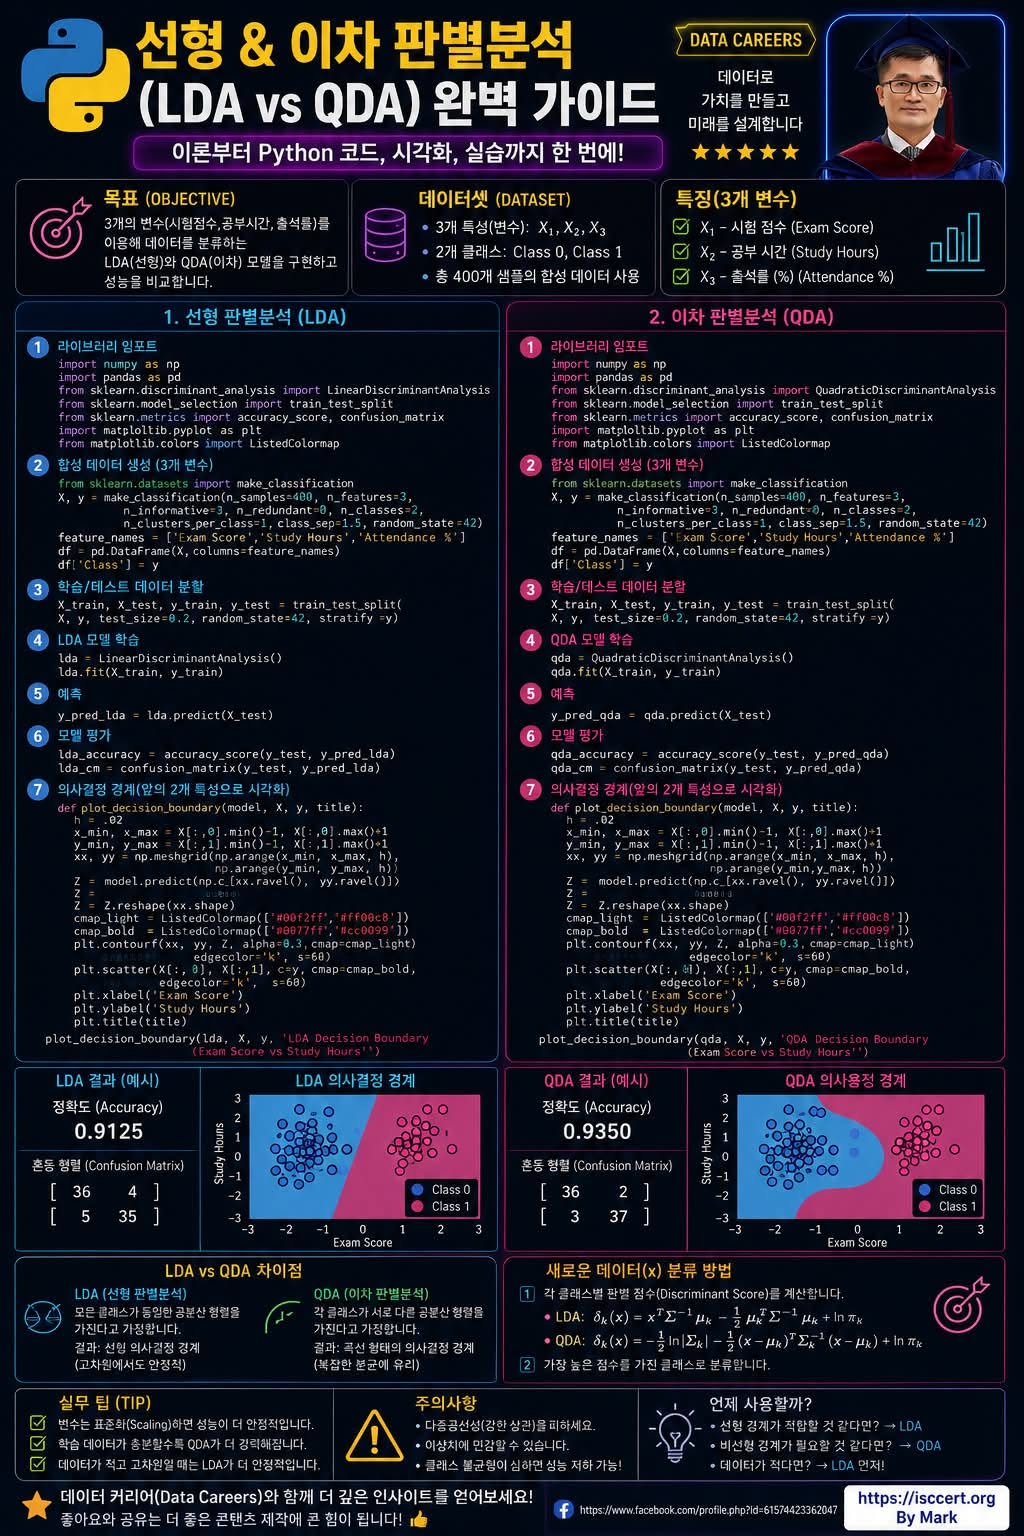
비슷해 보이지만, 데이터의 특성에 따라 성능이 크게 달라지는 두 가지 대표적인 판별분석(Discriminant Analysis) 알고리즘을
이해해 보세요.
머신러닝에는 다양한 분류(Classification) 알고리즘이 있지만, *LDA(Linear Discriminant Analysis)*와 *QDA(Quadratic Discriminant Analysis)*는 통계학과 머신러닝을 연결하는 가장 대표적인 확률 기반 분류 기법입니다.
두 알고리즘 모두 *베이즈 분류(Bayes Classification)*를 기반으로 하지만, *데이터를 구분하는 결정 경계(Decision Boundary)*를 만드는 방식이 다릅니다. 이 차이를 이해하면 데이터의 특성에 맞는 모델을 훨씬 효과적으로 선택할 수 있습니다.
LDA(선형 판별분석)란?
LDA는 모든 클래스가 *동일한 공분산(Covariance Matrix)*을 가진다고 가정합니다.
이 가정을 바탕으로 직선(Linear) 형태의 결정 경계를 생성하여 데이터를 분류합니다.
장점
* 학습 속도가 매우 빠르다.
* 계산량이 적어 대용량 데이터에 적합하다.
* 데이터가 적어도 안정적인 성능을 보인다.
* 해석이 쉬워 통계 및 머신러닝 입문에 적합하다.
대표 활용 분야
* 의료 데이터 분석
* 고객 이탈 예측
* 신용평가
* 품질관리
* 생물정보학
QDA(이차 판별분석)란?
QDA는 클래스마다 서로 다른 공분산 행렬을 허용합니다.
따라서 곡선(Quadratic) 형태의 결정 경계를 생성하여 더 복잡한 데이터 구조를 학습할 수 있습니다.
장점
* 비선형 데이터 분류에 강하다.
* 복잡한 클래스 분포를 잘 표현한다.
* 데이터 패턴이 다양한 경우 높은 정확도를 기대할 수 있다.
대표 활용 분야
* 영상 인식
* 의료 진단
* 금융 리스크 분석
* 생체인식
* 고차원 데이터 분석
LDA와 QDA의 핵심 차이
구분 LDA QDA
결정 경계 직선(Linear) 곡선(Quadratic)
공분산 가정 동일 클래스별 서로 다름
계산 속도 매우 빠름 상대적으로 느림
데이터 요구량 적음 많을수록 유리
과적합 위험 낮음 상대적으로 높음
해석성 매우 높음 다소 복잡
Python(Scikit-learn)으로 쉽게 구현
Scikit-learn에서는 몇 줄의 코드만으로 LDA와 QDA를 구현할 수 있습니다.
대표적인 절차는 다음과 같습니다.
데이터 준비(Data Preparation)
학습용/테스트용 데이터 분리
LDA 또는 QDA 모델 생성
모델 학습(Fit)
예측(Predict)
정확도(Accuracy), 혼동행렬(Confusion Matrix), 분류 리포트(Classification Report) 평가
결정 경계(Decision Boundary) 시각화
실무에서는 이 과정을 반복하며 모델 성능을 비교하고 최적의 알고리즘을 선택합니다.
언제 LDA를 선택해야 할까?
데이터가 비교적 단순한 구조일 때
클래스 간 분산이 비슷할 때
학습 데이터가 적을 때
빠른 예측 속도가 중요할 때
과적합을 줄이고 싶을 때
언제 QDA를 선택해야 할까?
클래스마다 분산이 크게 다를 때
비선형 패턴이 존재할 때
충분한 학습 데이터를 확보한 경우
복잡한 데이터 구조를 표현해야 할 때
정확도를 최우선으로 고려할 때
머신러닝 실무에서 기억해야 할 팁
데이터를 표준화(Scaling)하면 모델 성능이 안정되는 경우가 많습니다.
학습 전에 데이터의 분포와 공분산 구조를 확인하는 습관이 중요합니다.
단순히 정확도(Accuracy)만 보지 말고 Precision, Recall, F1-Score도 함께 평가해야 합니다.
교차검증(Cross Validation)을 활용하면 모델의 일반화 성능을 더욱 신뢰할 수 있습니다.
LDA와 QDA는 비교 실험을 통해 데이터에 가장 적합한 모델을 선택하는 것이 바람직합니다.
핵심 정리
LDA와 QDA는 모두 훌륭한 분류 알고리즘이지만, 어느 것이 항상 더 우수한 것은 아닙니다.
* LDA는 단순하고 안정적인 데이터에서 뛰어난 성능을 발휘하며 빠르고 해석이 쉽습니다.
* QDA는 복잡한 비선형 데이터에서 더욱 유연한 결정 경계를 만들어 높은 성능을 기대할 수 있습니다.
결국 최고의 모델은 데이터의 특성과 문제를 가장 잘 이해하고 선택한 모델입니다.
머신러닝에서는 복잡한 알고리즘을 사용하는 것보다 데이터를 올바르게 이해하고 적합한 모델을 선택하는 능력이 더 큰 경쟁력이 됩니다.
여러분은 머신러닝 프로젝트에서 LDA와 QDA를 사용해 본 경험이 있으신가요?
분류 문제에서 어떤 알고리즘을 선택했고, 어떤 성능 차이를 경험했는지 댓글로 함께 공유해 주세요!
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)