
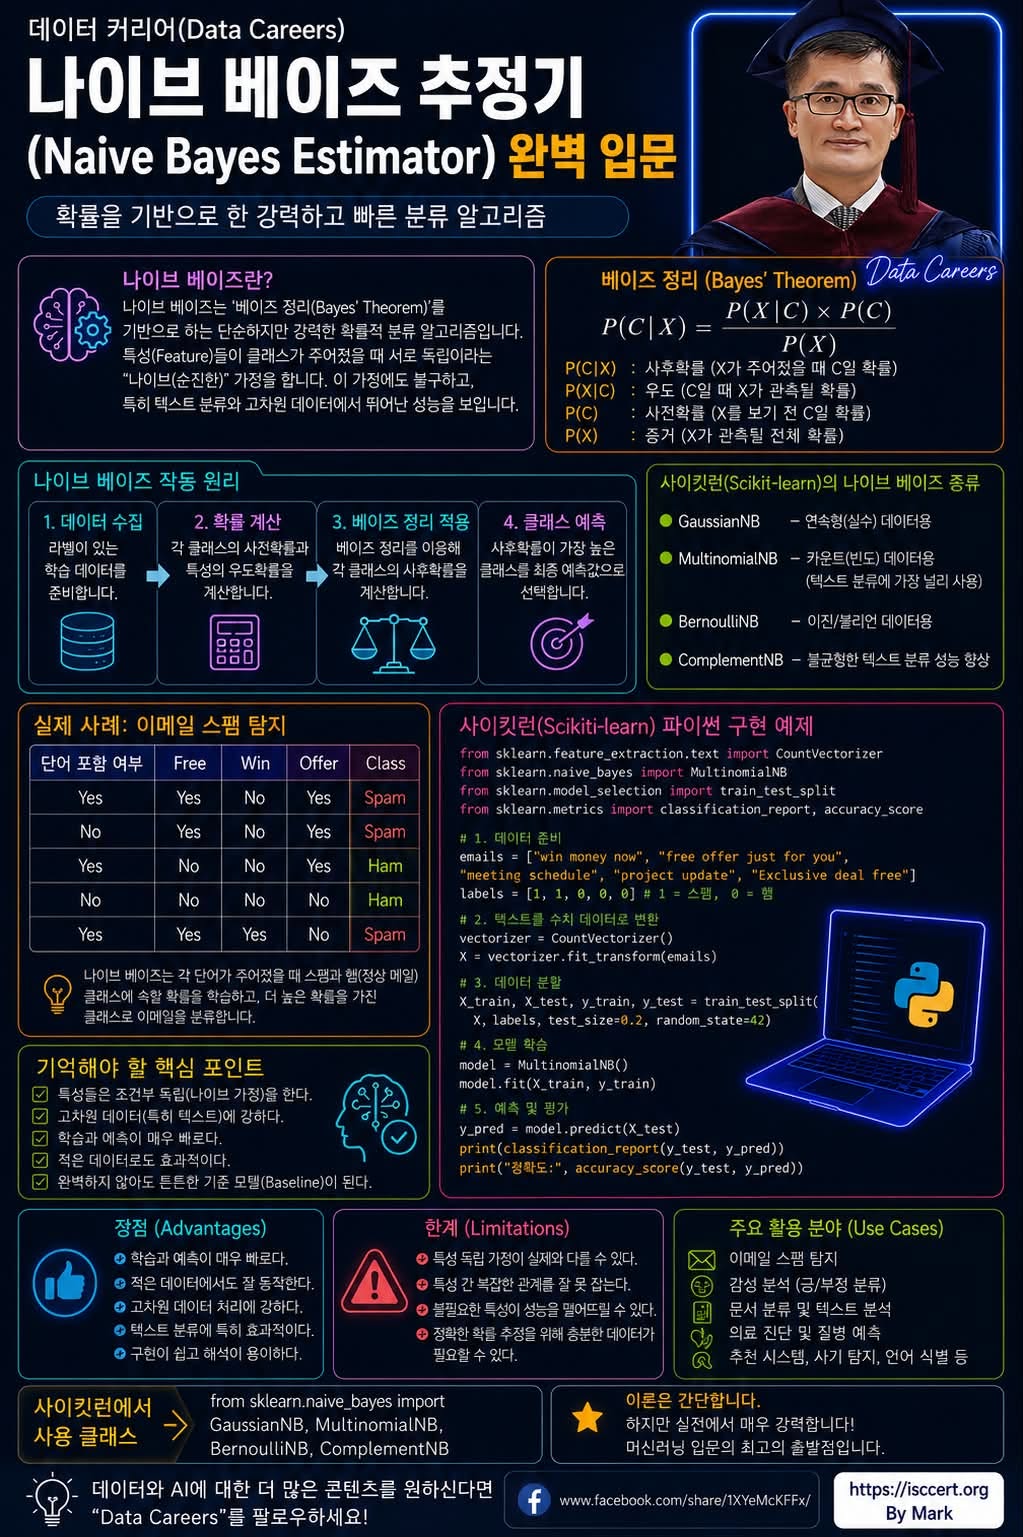
최신 AI 시대에는 대규모 언어모델(LLM)과 딥러닝이 주목받고 있지만, 기초를 탄탄히 이해하는 것이 진정한 AI 전문가로 가는 가장 빠른 길입니다.
그중에서도 나이브 베이즈(Naive Bayes)는 가장 배우기 쉽고, 가장 빠르게 적용할 수 있으며, 지금도 다양한 산업에서 활발하게 사용되는 대표적인 확률 기반 분류 알고리즘입니다.
나이브 베이즈란?
나이브 베이즈는 베이즈 정리(Bayes’ Theorem)를 기반으로 하는 지도학습(Supervised Learning) 분류 알고리즘입니다.
’Naive(순진한)’라는 이름은 알고리즘이 약해서가 아니라,
“각 특징(Feature)은 클래스가 주어지면 서로 독립적이다.”
라는 단순한 가정을 사용하기 때문입니다.
현실에서는 이러한 가정이 완벽하게 성립하지 않는 경우가 많지만, 놀랍게도 실제 문제에서는 높은 정확도와 뛰어난 성능을 보여줍니다.
나이브 베이즈의 동작 과정
알고리즘의 흐름은 매우 직관적입니다.
① 학습 데이터 준비
* 정답(Label)이 포함된 데이터를 수집합니다.
② 확률 계산
* 각 클래스의 사전확률(Prior Probability)과 특징별 우도(Likelihood)를 계산합니다.
③ 베이즈 정리 적용
* 새로운 데이터가 들어오면 사후확률(Posterior Probability)을 계산합니다.
④ 최종 분류
* 가장 높은 확률을 가진 클래스를 최종 결과로 선택합니다.
이처럼 계산 과정이 단순하기 때문에 학습 속도와 예측 속도가 매우 빠르며, 대용량 데이터에서도 효율적으로 동작합니다.
대표적인 활용 사례 : 이메일 스팸 탐지
나이브 베이즈의 가장 유명한 사례는 스팸 메일 분류입니다.
예를 들어 이메일에 다음과 같은 단어가 자주 등장한다면,
Free
Win
Offer
Prize
알고리즘은 해당 이메일이 스팸일 확률을 계산합니다.
반대로 업무 관련 단어가 많이 포함되어 있다면 정상 메일(Ham)로 분류합니다.
오늘날의 이메일 필터링, 뉴스 분류, 감성 분석 기술의 기초에는 이러한 확률 기반 분류 기법이 활용되고 있습니다.
Scikit-learn에서 제공하는 4가지 나이브 베이즈
데이터의 특성에 따라 적합한 모델을 선택하는 것이 중요합니다.
GaussianNB
* 연속형(실수) 데이터
* 의료 데이터, 센서 데이터, 금융 데이터
MultinomialNB
* 단어 빈도(Count) 데이터
* 이메일 스팸 탐지
* 문서 분류
* 감성 분석
* 뉴스 분류
BernoulliNB
* 0 또는 1과 같은 이진(Binary) 데이터
* 단어 포함 여부 분석
* Boolean Feature 데이터
ComplementNB
* 불균형(Imbalanced) 텍스트 데이터
* 클래스 간 데이터 수 차이가 큰 경우 성능 향상
나이브 베이즈의 장점
학습 속도가 매우 빠르다.
예측 속도가 뛰어나다.
적은 데이터에서도 성능이 우수하다.
고차원 데이터(Text 등)에 강하다.
구현이 매우 간단하다.
해석이 쉽다.
머신러닝 프로젝트의 Baseline Model로 많이 사용된다.
한계도 이해해야 합니다
모든 알고리즘이 그렇듯 단점도 존재합니다.
특징 간 독립성을 가정한다.
변수 간 상관관계가 크면 성능이 떨어질 수 있다.
불필요한 특징이 많으면 정확도가 감소할 수 있다.
복잡한 패턴은 딥러닝이나 앙상블 모델이 더 뛰어난 성능을 보일 수 있다.
따라서 데이터의 특성과 문제 유형에 맞는 알고리즘 선택이 중요합니다.
다양한 산업에서 활용되는 나이브 베이즈
나이브 베이즈는 지금도 다양한 분야에서 활용되고 있습니다.
이메일 스팸 탐지
감성 분석(Sentiment Analysis)
뉴스 및 문서 자동 분류
의료 진단 및 질병 예측
금융 사기(Fraud) 탐지
추천 시스템
언어 식별(Language Identification)
사이버 보안 및 악성코드 분류
특히 자연어 처리(NLP) 분야에서는 여전히 매우 중요한 기본 알고리즘으로 평가받고 있습니다.
머신러닝을 시작하는 사람이라면 반드시 이해해야 하는 알고리즘
나이브 베이즈는 화려한 딥러닝 모델은 아니지만,
확률 이론
통계학
지도학습
텍스트 분류
머신러닝 파이프라인
을 이해하는 데 가장 좋은 출발점입니다.
Scikit-learn에서는 몇 줄의 Python 코드만으로 구현할 수 있어 입문자부터 실무자까지 폭넓게 활용되고 있습니다.
복잡한 모델을 배우기 전에 나이브 베이즈를 충분히 이해한다면, 이후 로지스틱 회귀(Logistic Regression), SVM, 랜덤 포레스트(Random Forest), XGBoost, 딥러닝까지 훨씬 쉽게 학습할 수 있습니다.
기억하세요!
“복잡한 모델이 항상 최고의 모델은 아닙니다.”
나이브 베이즈는 단순한 구조와 빠른 계산, 높은 해석 가능성을 바탕으로 지금도 머신러닝 실무에서 중요한 역할을 수행하고 있습니다.
기초를 탄탄히 다지는 것이 AI 전문가로 성장하는 가장 확실한 투자입니다.
여러분은 나이브 베이즈를 어떤 프로젝트에서 활용해 보셨나요?
스팸 탐지, 감성 분석, 문서 분류, 추천 시스템 등 다양한 활용 경험이나 학습 팁을 댓글로 함께 공유해 주세요!
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)