
AI의 성능은 모델만으로 결정되지 않습니다. “검색(Retrieval)을 얼마나 잘했는가?”가
AI의 품질을 좌우합니다.
많은 기업이 ChatGPT,
Claude, Gemini와 같은 LLM을 활용해
AI 챗봇, 사내 Copilot,
AI 검색 시스템을 구축하고 있습니다.
하지만 실제 운영 환경에서는 이런 질문을 자주 받습니다.
* “AI가 왜 엉뚱한 답을 했지?”
* “검색은 했는데 관련 없는 문서를 가져왔네.”
* “그럴듯한데 사실과 다른 답변이다.”
* “같은 질문인데 답이 계속 달라진다.”
이러한 문제는 대부분 LLM 자체의 문제가 아니라 RAG(Retrieval-Augmented Generation)의
품질 문제에서 발생합니다.
즉,
좋은 AI는 좋은 검색에서 시작됩니다.
그래서 최근 AI 개발에서 가장 중요한 분야 중 하나가
*RAG Evaluation(검색 증강 생성 평가)*입니다.
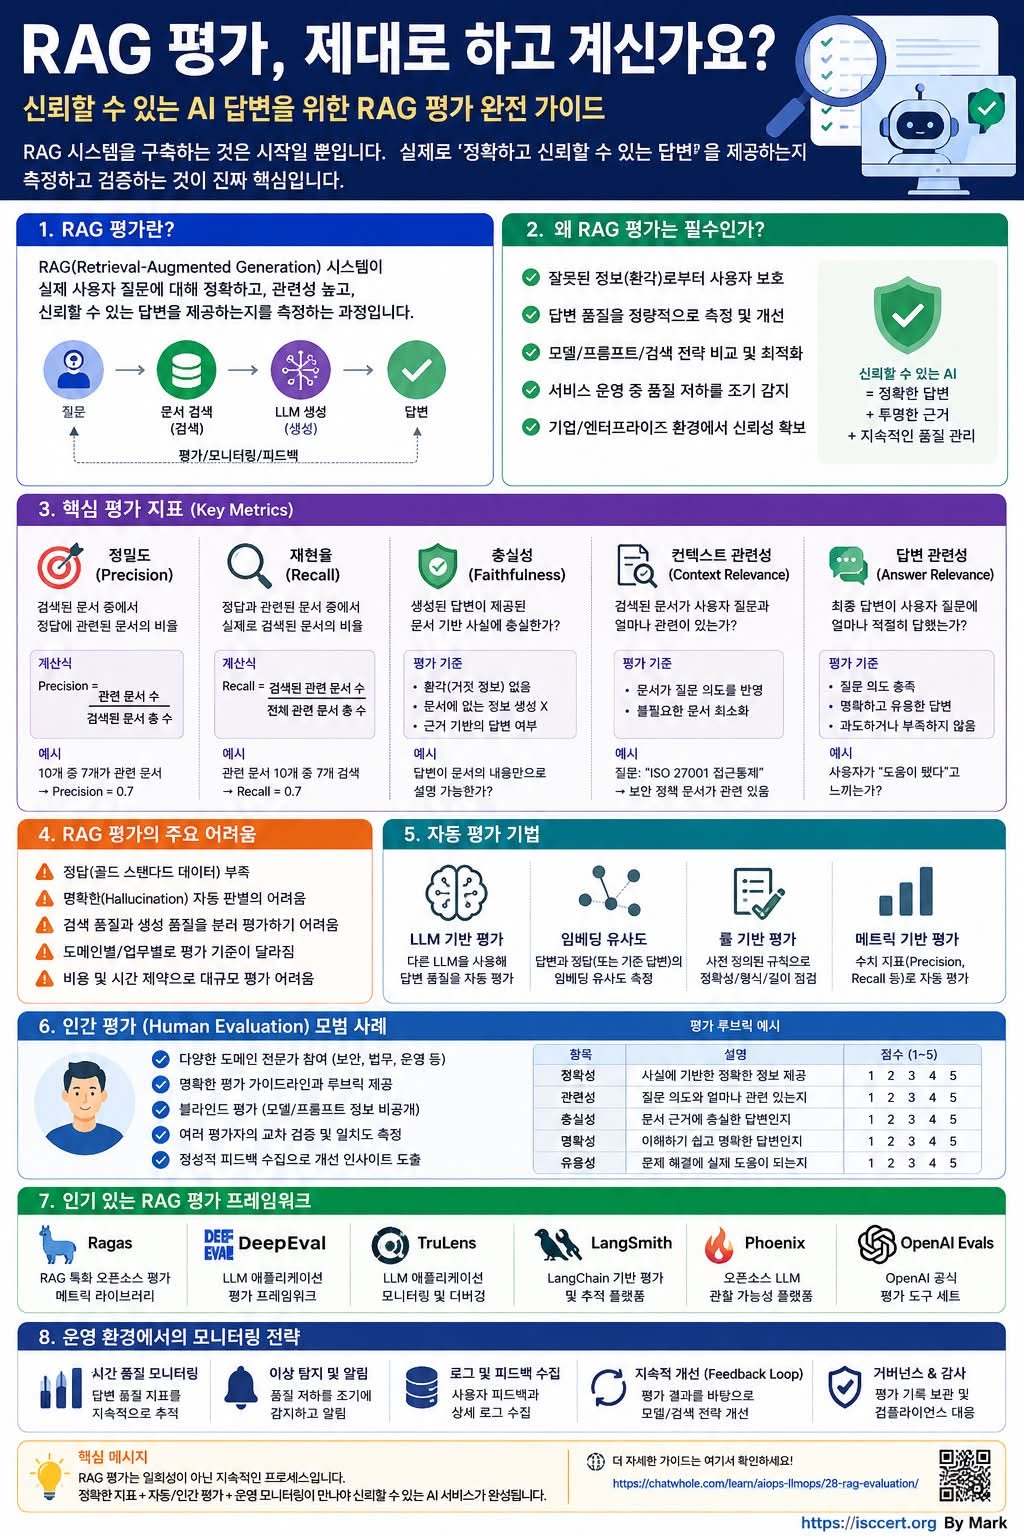
① RAG 평가(RAG Evaluation)란?
RAG는 AI가 답변하기 전에 관련 문서를 검색한 후,
그 문서를 근거로 답을 생성하는 구조입니다.
즉,
질문 → 문서 검색 → 관련 문맥 추출 → AI 답변 생성
이 전체 과정이 제대로 수행되었는지 평가하는 것이
바로 RAG Evaluation입니다.
단순히
“답이 맞다.”
만 평가하는 것이 아닙니다.
다음과 같은 모든 과정을 함께 평가합니다.
* 검색은 제대로 되었는가?
* 검색 문서는 적절했는가?
* AI가 문서를 왜곡하지 않았는가?
* 사용자 질문과 관련 있었는가?
* 최종 답변이 도움이 되었는가?
② 왜 RAG 평가가 중요한가?
LLM은 매우 똑똑합니다.
하지만
검색된 문서가 틀리면
AI도 틀린 답을 합니다.
즉,
Garbage In → Garbage Out
입니다.
따라서
RAG의 품질이 높을수록
AI의 신뢰성도 함께 올라갑니다.
기업에서는 다음과 같은 이유 때문에 반드시 평가합니다.
정확도 향상
환각(Hallucination) 감소
고객 신뢰 확보
검색 성능 개선
운영 품질 모니터링
AI 지속 개선
③ 반드시 측정해야 하는 핵심 평가 지표
1. Precision (정밀도)
검색된 문서 중
실제로 관련 있는 문서의 비율입니다.
예를 들어
10개의 문서를 검색했는데
7개만 관련 있다면
Precision = 70%
정밀도가 높을수록
불필요한 문서를 줄일 수 있습니다.
2. Recall (재현율)
실제로 존재하는 관련 문서를
얼마나 많이 찾았는지를 의미합니다.
예를 들어
관련 문서가 10개 있는데
6개만 찾았다면
Recall = 60%
검색 누락 여부를 확인하는 매우 중요한 지표입니다.
3. Faithfulness (충실성)
가장 중요한 평가입니다.
AI가
검색된 문서에 있는 내용만으로 답했는가?
아니면
없는 내용을 상상해서 만들었는가?
를 평가합니다.
즉,
Hallucination을 측정하는 핵심 지표입니다.
4. Context Relevance
검색된 문서가
질문과 얼마나 관련 있는지를 평가합니다.
예를 들어
질문이
ISO/IEC 27001 접근통제 정책
인데
검색 결과가
클라우드 비용 최적화라면
검색 품질이 매우 낮은 것입니다.
5. Answer Relevance
최종 답변이
사용자 질문을 제대로 해결했는지를 평가합니다.
검색이 잘 되었더라도
답변이 질문을 해결하지 못하면
좋은 AI가 아닙니다.
④ RAG 시스템이 어려운 이유
실제 운영에서는 다양한 문제가 발생합니다.
검색 품질 부족
중복 문서 검색
Chunk 크기 오류
임베딩 품질 문제
오래된 문서 검색
Metadata 부족
환각(Hallucination)
답변 일관성 부족
긴 문맥(Context Window) 한계
도메인 전문성 부족
그래서
단순히 벡터DB를 구축했다고
좋은 RAG가 되는 것은 아닙니다.
⑤ 자동 평가(Automated Evaluation)
최근에는 AI가 AI를 평가하는 시대입니다.
대표적인 자동 평가 방식은 다음과 같습니다.
LLM-as-a-Judge
다른 LLM이
답변 품질을 평가합니다.
Embedding Similarity
기준 답변과
생성 답변의 의미적 유사도를 계산합니다.
Rule-based Evaluation
규칙 기반으로
형식, 길이, 키워드 등을 자동 검사합니다.
Metric 기반 평가
Precision
Recall
Faithfulness
Context Score
Answer Score 등을
자동 계산합니다.
⑥ 사람이 평가해야 하는 부분
자동 평가만으로는 부족합니다.
실제 서비스에서는 전문가 평가가 반드시 필요합니다.
평가 항목은 다음과 같습니다.
* 정확성
* 이해하기 쉬운가
* 논리성
* 근거 제시 여부
* 실무 활용 가능성
* 설명의 명확성
* 사용자 만족도
특히 의료·법률·금융·정보보안 분야는 사람의 검증이 필수적입니다.
⑦ 많이 사용하는 RAG 평가 프레임워크
현재 가장 많이 활용되는 오픈소스 및 상용 프레임워크는 다음과 같습니다.
Ragas
RAG 전용 평가 프레임워크로 Precision, Faithfulness, Context Relevance 등을 자동 측정합니다.
DeepEval
LLM 애플리케이션을 위한 자동 테스트 및 평가 도구로 다양한 평가 지표를 제공합니다.
TruLens
LLM 애플리케이션의 품질, 추적성, 디버깅을 지원하는 모니터링 플랫폼입니다.
LangSmith
LangChain 기반 애플리케이션의 실행 추적, 디버깅, 평가를 지원하는 개발 플랫폼입니다.
Phoenix
LLM의 관찰성(Observability)과 운영 모니터링에 특화된 플랫폼입니다.
OpenAI Evals
LLM 성능을 체계적으로 검증하기 위한 평가 프레임워크입니다.
⑧ 운영 환경에서는 지속적인 모니터링이 핵심입니다.
RAG는 한 번 구축했다고 끝나는 시스템이 아닙니다.
운영 중에는 지속적인 관리가 필요합니다.
검색 성공률
응답 속도
사용자 만족도
오류 발생률
환각 발생 빈도
토큰 사용량
Vector DB 품질
Prompt 변경 효과
모델 교체 영향
로그 분석
이러한 지표를 지속적으로 모니터링하고 개선해야 안정적인 AI 서비스를 제공할 수 있습니다.
핵심 정리
오늘날 AI의 경쟁력은
“얼마나 큰 모델을 사용하는가”
보다
”얼마나 정확한 정보를 검색하고, 신뢰할 수 있는 답변을 생성하는가”에 달려 있습니다.
RAG 평가(RAG Evaluation)는 AI 시스템의 품질을 객관적으로 측정하고 지속적으로 개선하기 위한 필수 과정입니다. 정밀도(Precision),
재현율(Recall), 충실성(Faithfulness),
컨텍스트 관련성(Context Relevance), 답변 관련성(Answer Relevance)을
체계적으로 관리하고, 자동 평가와 전문가 평가를 함께 운영해야
신뢰할 수 있는 AI 서비스를 구축할 수 있습니다.
특히 기업 환경에서는 RAG + LLMOps + AIOps + 지속적인 운영 모니터링을
결합해야 환각을 줄이고
정확도를 높이며, 사용자에게 안정적이고
신뢰성 높은 AI 서비스를 제공할 수 있습니다.
AI의 미래는 단순히 더 강력한 모델이 아니라, 지속적으로 평가하고 개선하는
AI 운영 체계에 달려 있습니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)