
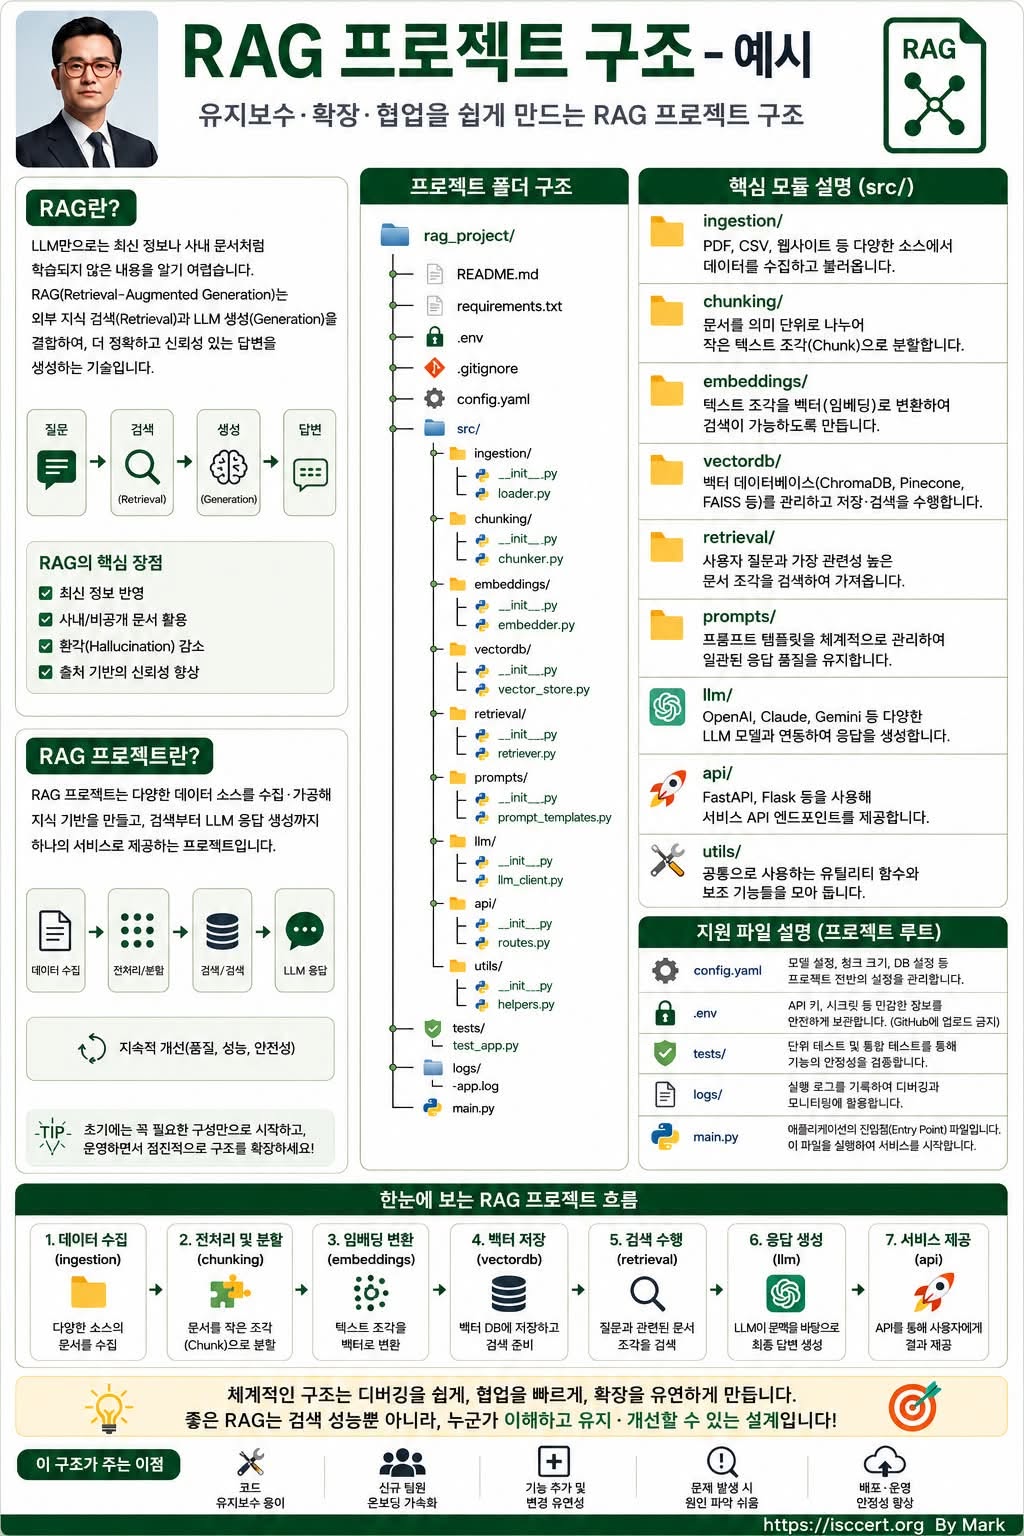
검색 성능만 좋은 RAG가 아니라, 유지보수·확장·협업이 가능한 RAG를 만들어야 합니다.
RAG를 처음 공부할 때는 하나의 Python 파일이나 Jupyter Notebook만으로도 충분합니다. 하지만 PDF·웹사이트·사내문서가 늘어나고,
Vector DB와 여러 LLM을 연결하고, API·테스트·모니터링까지 추가되기 시작하면
프로젝트는 빠르게 복잡해집니다.
그래서 실무형 RAG는 기능별 책임을 처음부터 분리하는 프로젝트 구조가 중요합니다.
RAG란?
“RAG(Retrieval-Augmented Generation, 검색 증강 생성)”는 LLM이 자신의 학습 데이터만으로 답변하지 않고,
“외부 지식에서 질문과 관련된 정보를 먼저 검색(Retrieval)한 뒤 그 정보를 근거로 답변을 생성(Generation)”
하는 방식입니다.
쉽게 표현하면,
사용자 질문 → 관련 자료 검색 → 필요한 문맥(Context) 확보 → LLM에 전달 → 근거 기반 답변 생성
의 과정입니다.
이를 통해 최신 정보나 사내 비공개 문서를 활용할 수 있고, LLM의 환각(Hallucination)을 줄이며 답변의 신뢰성과 근거성을 높이는 것이 RAG의 핵심 목적입니다.
RAG 프로젝트란?
RAG 프로젝트는 단순히 “문서를 검색해서 LLM에 전달하는 코드”가 아닙니다.
데이터 수집 → 전처리·분할 → 임베딩 → 벡터 저장 → 검색 → 프롬프트 구성 → LLM 응답 → API 서비스
전체 파이프라인을 하나의 안정적인 시스템으로 설계하고 운영하는 프로젝트입니다.
즉, 좋은 RAG 프로젝트는 검색 정확도뿐 아니라 데이터 품질, 코드 구조, 보안, 테스트, 모니터링, 확장성까지 함께 고려해야 합니다.
실무형 RAG 프로젝트의 핵심 구조
1) ingestion/ — PDF, CSV, 웹사이트, 데이터베이스 등에서 데이터를 수집합니다.
2) chunking/ — 긴 문서를 검색하기 좋은 작은 의미 단위인 Chunk로 분할합니다.
3) embeddings/ — 텍스트를 의미를 표현하는 벡터(Vector)로 변환합니다.
4) vectordb/ — ChromaDB, Pinecone, FAISS 등의 Vector Store에 임베딩을 저장·관리합니다.
5) retrieval/ — 사용자 질문과 의미적으로 가장 관련성이 높은 문서를 검색합니다.
6) prompts/ — 검색된 Context를 LLM에 전달하기 위한 Prompt Template을 관리합니다.
7) llm/ — OpenAI·Claude·Gemini·Local LLM 등과 연결하여 최종 답변을 생성합니다.
8)api/ — FastAPI·Flask 등을 이용해 RAG 기능을 실제 서비스에서 사용할 수 있도록 제공합니다.
9) utils/ — 여러 모듈에서 공통으로 사용하는 함수와 보조 기능을 관리합니다.
그리고 실제 운영환경에서는 핵심 코드만큼 지원 파일의 관리도 중요합니다.
config.yaml은 모델·Chunk·DB 등의 설정을 중앙관리하고, .env는 API Key와 Secret을 코드에서 분리합니다. tests/는
변경으로 기존 기능이 깨지는 것을 방지하고, logs/는 장애 분석과 모니터링에 활용하며,
main.py는 전체 애플리케이션을 시작하는 Entry Point 역할을 합니다.
한눈에 보는 RAG 동작 흐름
① 데이터 수집(Ingestion)
→ ② 전처리·분할(Chunking)
→ ③ 임베딩 변환(Embeddings)
→ ④ 벡터 저장(Vector DB)
→ ⑤ 관련 문서 검색(Retrieval)
→ ⑥ LLM 답변 생성(Generation)
→ ⑦ API를 통한 서비스 제공
여기서 특히 중요한 것은 ⑤ Retrieval입니다.
아무리 뛰어난 LLM을 사용해도 잘못된 문서를 검색해서 Context로 제공하면 좋은 답변을 만들기 어렵습니다. 그래서
Production RAG에서는 단순한 Vector Similarity Search를 넘어
Metadata Filtering, Hybrid Search,
Query Rewriting, Reranking,
Citation, Evaluation 등을
단계적으로 적용하게 됩니다.
왜 프로젝트 구조가 중요한가?
작은 RAG 데모에서는 모든 코드를 한 파일에 넣어도 동작합니다. 그러나 실제 서비스에서는 문서가 늘어나고,
모델이 바뀌고, Vector DB를 교체하고,
여러 개발자가 동시에 작업하며, 장애와 보안 문제까지 관리해야 합니다.
모듈을 명확하게 분리하면 코드 유지보수가 쉬워지고, 신규 개발자의 온보딩이 빨라지며,
특정 기능만 독립적으로 테스트하거나 교체할 수 있습니다. 나아가 CI/CD·Observability·Evaluation·Security까지 연결하기도 훨씬 쉬워집니다.
결국 좋은 RAG의 기준은 이것입니다.
좋은 RAG는 단순히 “검색을 잘하는 시스템”이 아닙니다.
누군가 쉽게 이해하고, 테스트하고, 운영하고, 지속적으로 개선할 수 있는 시스템입니다.
처음에는 필요한 구성만으로 작게 시작하십시오.
그리고 서비스가 성장함에 따라 Retrieval → Reranking → Evaluation → Monitoring → Security → Governance까지 단계적으로 확장하는 것이 실무적인 접근입니다.
RAG의 경쟁력 = 검색 품질 × 데이터 품질 × LLM 품질 × 시스템 설계 × 평가·운영 역량
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)