
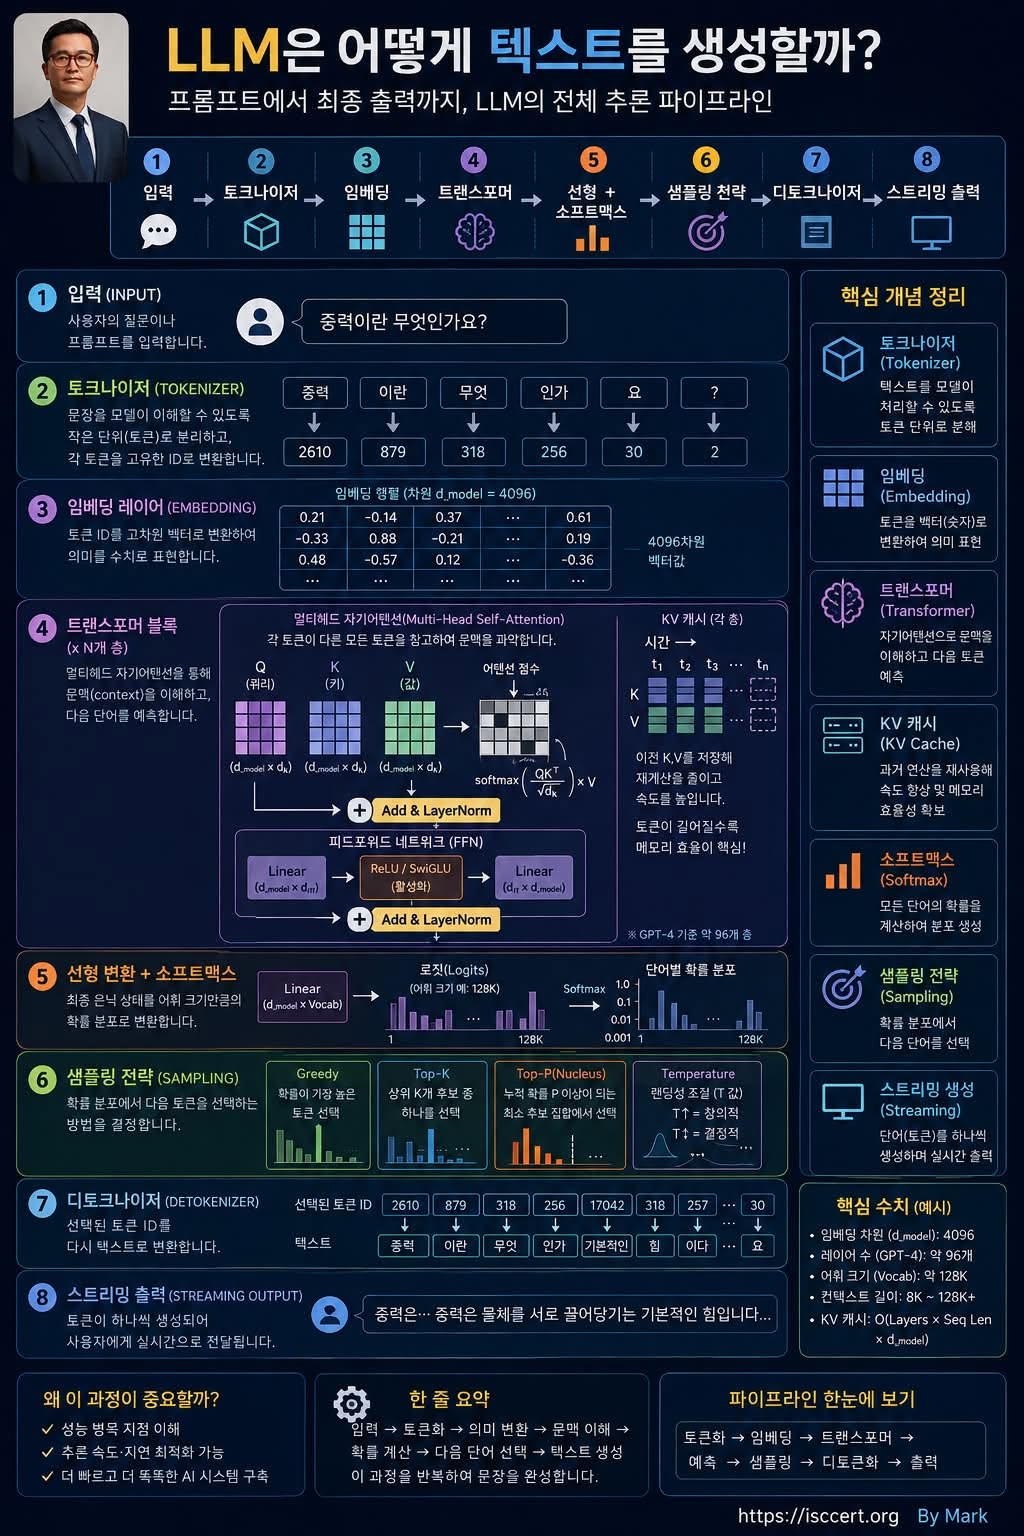
ChatGPT, Claude, Gemini 같은 LLM(Large Language Model)에 질문하면
어떻게 몇 초 만에 자연스러운 답변이 만들어질까요?
핵심 원리는 의외로 간단합니다.
LLM은 완성된 문장을 머릿속에서
한꺼번에 만들어내는 것이 아니라, 현재까지의 문맥을 바탕으로
‘다음에 올 가능성이 높은 토큰’을 하나씩 예측합니다.
하지만 그 한 개의 토큰을 선택하기 위해
내부에서는 매우 복잡한 계산이 일어납니다.
① 입력 — Prompt
먼저 사용자가 질문합니다.
“중력이란 무엇인가요?”
이 문장이 LLM 추론 파이프라인의 출발점입니다.
② 토큰화 — Tokenization
LLM은 우리가 입력한 문장을 사람처럼 그대로 읽지 않습니다.
텍스트를 Token이라는 작은 처리 단위로 분해하고 각각을 숫자 ID로 변환합니다.
쉽게 말하면,
문장 → 토큰 → 숫자
로 바꾸는 과정입니다.
③ 임베딩 — Embedding
하지만 숫자 ID만으로는 단어의 의미와 관계를 충분히 계산하기 어렵습니다.
그래서 각각의 토큰을 수백~수천 차원의 벡터(Vector) 로 변환합니다.
이 벡터 공간에서는 단어와 개념 사이의 의미적 관계를 수치적으로 표현할 수 있습니다.
즉,
Token ID → 의미를 표현하는 고차원 벡터
로 바뀌는 것입니다.
④ Transformer — 문맥을 이해하는 핵심 엔진
여기서 LLM의 핵심인 Transformer가 등장합니다.
Transformer의 Self-Attention은 각 토큰이 다른 토큰들과 어떤 관계를 가지고 있는지 계산합니다.
예를 들어,
“은행에서 돈을 찾았다.”
“강가의 은행(bank)에 앉았다.”
같은 단어라도 주변 문맥에 따라 의미가 달라질 수 있습니다.
Transformer는 이런 관계를 여러 층에 걸쳐 계산하면서 현재 문맥에서 무엇이 중요한지 파악합니다.
그리고 Multi-Head Attention을 이용해 하나의 관계만 보는 것이 아니라 여러 관점에서 토큰 간 관계를 동시에 분석합니다.
⑤ Logits + Softmax — 다음 토큰의 확률 계산
Transformer의 계산이 끝나면 다음에 등장할 수많은 후보 토큰에 점수(Logits)가 만들어집니다.
Softmax는 이 점수들을 확률 분포로 변환합니다.
예를 들어,
“중력은 물체를 서로…”
다음에
끌어당기는 → 62%
움직이는 → 12%
밀어내는 → 4%
연결하는 → 3%
기타 → 19%
처럼 후보가 만들어지는 방식이라고 이해하면 쉽습니다.
실제 모델의 후보 공간은 훨씬 큽니다.
⑥ Sampling — 다음 토큰 선택
항상 확률이 가장 높은 단어만 선택하면 문장이 지나치게 획일적일 수 있습니다.
그래서 모델은 다양한 Sampling 전략을 사용할 수 있습니다.
Greedy는 가장 높은 확률의 후보를 선택하고, Top-K는 상위 K개 후보 안에서 선택합니다. Top-P(Nucleus)는 누적 확률 기준으로 후보군을 제한하고, Temperature는 출력의 다양성과 무작위성에 영향을 줍니다.
Temperature가 낮으면 상대적으로 일관되고 결정적인 출력, 높아지면 다양하고 창의적인 출력이 나타나는 경향이 있습니다.
⑦ KV Cache — 이전 계산을 다시 하지 않는다
LLM이 긴 문장을 생성할 때 매번 처음부터 모든 계산을 반복한다면 매우 느려집니다.
그래서 이전 Attention 계산에서 얻은 Key와 Value 정보를 KV Cache에 저장해 재사용합니다.
이것이 긴 답변을 생성할 때 속도와 GPU 메모리 사용량을 결정하는 중요한 요소 중 하나입니다.
⑧ Detokenization — 숫자를 다시 글자로
선택된 Token ID를 다시 사람이 읽을 수 있는 텍스트로 변환합니다.
즉,
Token ID → Token → Text
과정을 거칩니다.
⑨ Streaming — 우리 화면에 한 토큰씩 나타난다
이 과정이 반복되면서 우리가 보는 화면에는 문장이 조금씩 나타납니다.
“중력…”
→ “중력은…”
→ “중력은 물체를…”
→ “중력은 물체를 서로 끌어당기는…”
이것이 ChatGPT나 Claude가 마치 실시간으로 글을 작성하는 것처럼 보이는 이유입니다.
LLM 추론의 핵심을 한 줄로 정리하면
Prompt → Tokenize →
Embed → Attention/Transformer →
Logits → Softmax →
Sampling → Next Token →
반복 → Detokenize →
Streaming
결국 LLM의 텍스트 생성은 거대한 ’다음 토큰 예측의 반복 과정’
이라고 볼 수 있습니다.
하지만 그 예측을 위해
Transformer가 방대한 파라미터와 문맥 정보를 이용해
매우 복잡한 계산을 수행하기 때문에 자연스러운 문장뿐 아니라
코드 작성, 번역,
요약, 추론,
질의응답 같은 능력이 나타납니다.
여기서 AI 엔지니어링이 시작됩니다
LLM의 원리를 이해하면 왜 GPU, Context Window, KV Cache, FlashAttention, Quantization, Prompt Engineering이 중요한지도 연결됩니다.
특히 추론 과정은 크게 Prefill과 Decode로 나누어 생각하면 좋습니다.
Prefill은 입력된 프롬프트를 처리하는 단계라
계산량의 영향을 크게 받고, Decode는
이전 상태와 KV Cache를 활용해 새로운 토큰을 순차적으로 생성하므로
메모리 대역폭과 캐시 관리가 중요해집니다.
그래서 LLM 성능 최적화는 단순히 “더 좋은 GPU를 사용한다”의 문제가 아닙니다.
모델 크기 + Context Length + KV Cache + Batch Size + Quantization + Attention 최적화 + Serving Architecture
전체를 함께 설계해야 합니다.
기억해야 할 핵심
LLM은 문장을 통째로 외워서 꺼내는 시스템이 아닙니다.
현재까지 주어진 문맥을 이용해 다음 토큰의 확률을 계산하고 하나를 선택한 뒤, 그 토큰을 다시 문맥에 추가해 다음 토큰을 예측합니다.
예측 → 선택 → 추가 → 다시 예측
이 반복이 우리가 보는 자연스러운 AI 답변을 만들어냅니다.
“LLM의 놀라운 문장 생성 능력 뒤에는 거대한 확률 계산과 Transformer의 반복 추론이 있습니다.”
.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)