
가장 먼저 예방합니다
오늘날의 소프트웨어는
‘잘 동작하는가?’ 보다 ‘지금 내부에서 무슨 일이 일어나고 있는가?’ 를
실시간으로 이해하는 것이 더 중요합니다.
클라우드, AI 에이전트,
MSA(Microservices), Kubernetes 환경에서는
장애가 발생한 뒤 대응하는 방식으로는 충분하지 않습니다. 이제는 관측 가능성(Observability)을 통해
문제를 미리 발견하고, 원인을 빠르게 분석하며,
지속적으로 시스템을 개선하는 시대입니다.
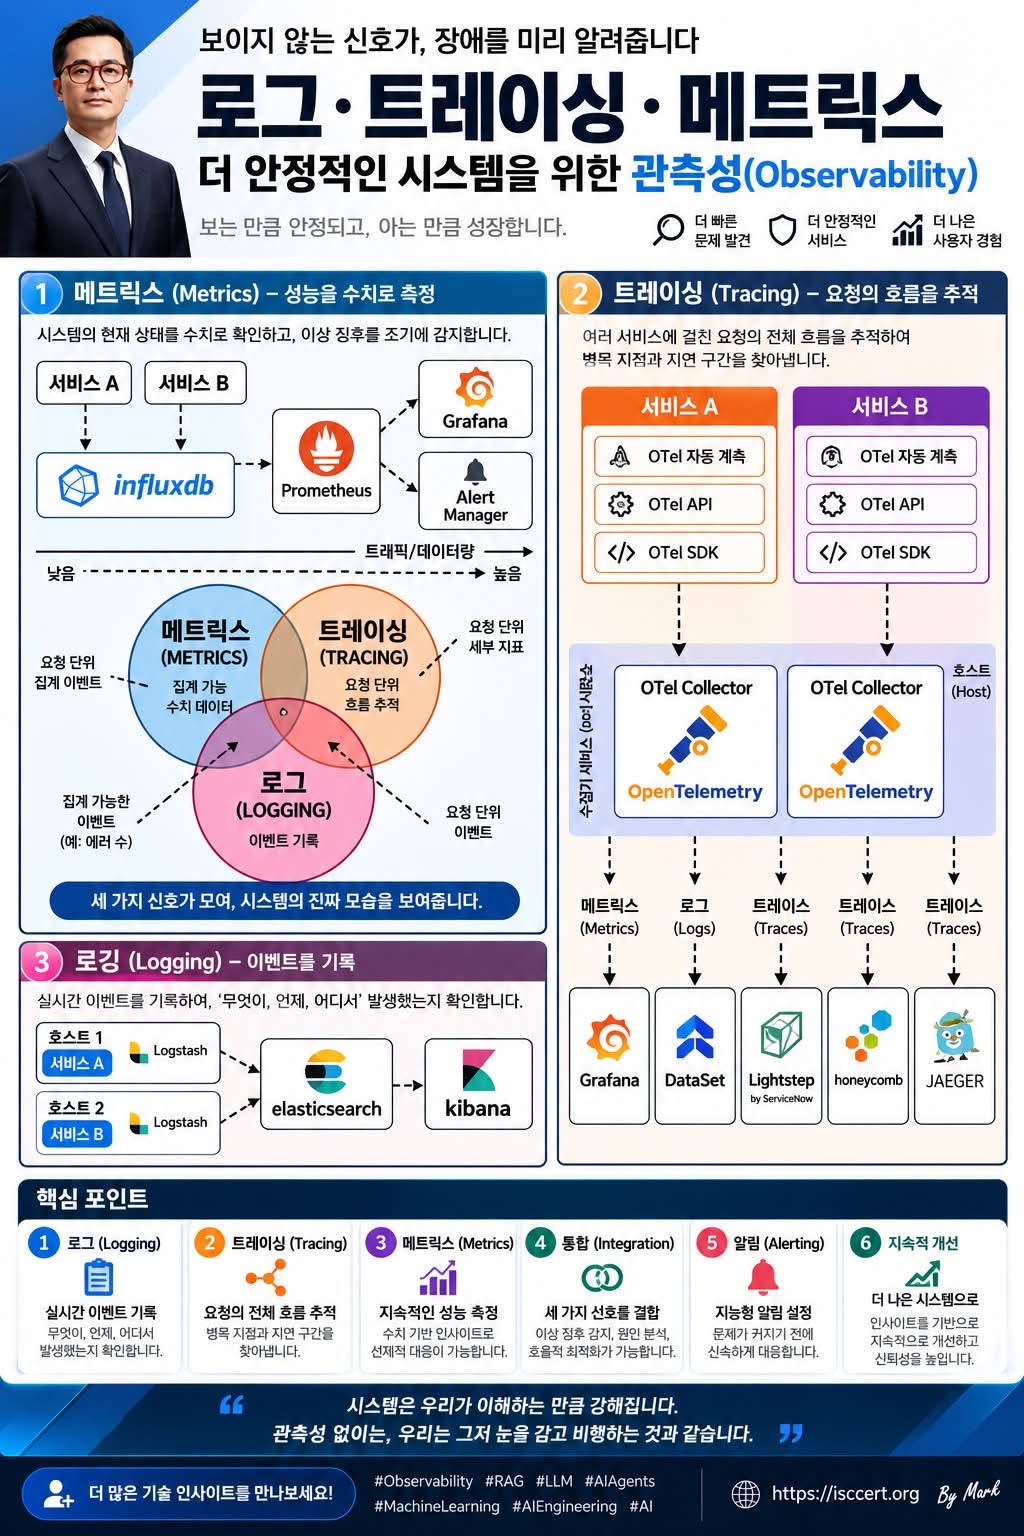
1. 메트릭(Metrics) — 시스템의 건강 상태를 숫자로 확인
메트릭은 CPU, 메모리, 디스크, 응답시간, TPS, 에러율과 같은 핵심 성능 지표(KPI) 를 지속적으로 수집합니다.
이를 통해
시스템 부하 증가 감지
성능 저하 조기 발견
용량 예측 및 확장 계획
SLA(Service Level Agreement) 준수 여부 확인
등을 실시간으로 확인할 수 있습니다.
“현재 시스템이 건강한가?” 에 가장 먼저 답해주는 데이터입니다.
2. 트레이싱(Tracing) — 요청(Request)의 이동 경로를 추적
사용자의 하나의 요청은 API Gateway를 거쳐 수많은 마이크로서비스를 통과합니다.
트레이싱은 이러한 요청이
* 어디를 거쳤는지
* 어느 서비스에서 지연이 발생했는지
* 어떤 API가 병목인지
* 장애가 어디에서 시작되었는지
를 하나의 흐름으로 보여줍니다.
특히 OpenTelemetry(OTel) 기반 분산 추적은 MSA 환경에서 필수 기술로 자리 잡고 있습니다.
3. 로깅(Logging) — 모든 이벤트를 기록하는 시스템의 블랙박스
로그는 시스템에서 발생하는 모든 이벤트를 시간순으로 저장합니다.
예를 들어
* 사용자 로그인
* 오류(Exception)
* API 호출
* 데이터 변경
* 보안 이벤트
등을 상세하게 기록합니다.
로그는 장애 원인을 가장 깊이 분석할 수 있는 디지털 증거(Evidence) 이며,
ISO/IEC 27001, ISO/IEC 27701, ISO/IEC 42001 같은 국제표준에서도 매우 중요한 통제 항목입니다.
4. 메트릭 + 트레이싱 + 로깅이 함께해야 진짜 Observability
세 가지 데이터를 각각 보면 일부 정보만 확인할 수 있습니다.
하지만 함께 분석하면
장애 원인(Root Cause Analysis)
성능 병목(Bottleneck)
사용자 영향도
시스템 이상 징후
보안 사고
까지 하나의 화면에서 종합적으로 이해할 수 있습니다.
이것이 바로 관측 가능성(Observability) 의 핵심 가치입니다.
5. Alerting — 장애를 사람이 발견하기 전에 AI가 알려준다
관측 데이터를 기반으로
* CPU 과부하
* 응답시간 증가
* 에러율 상승
* 비정상 접근
* 서비스 다운
등을 감지하면 자동으로 알림을 전송합니다.
Grafana Alert, Prometheus AlertManager, PagerDuty, Slack, Teams 등을 연계하면 24시간 자동 모니터링 체계를 구축할 수 있습니다.
6. 지속적인 개선(Continuous Improvement)
Observability는 단순한 모니터링 도구가 아닙니다.
수집된 데이터를 기반으로
* 성능 최적화
* 비용 절감(FinOps)
* 장애 예방
* AI 운영(AIOps)
* DevOps 자동화
를 반복적으로 개선하는 지속적 혁신(Continuous Improvement) 의 기반이 됩니다.
대표적인 Observability 기술 스택
Metrics
* Prometheus
* InfluxDB
* Grafana
Logging
* Elasticsearch
* Logstash
* Kibana(ELK)
Tracing
* OpenTelemetry
* Jaeger
* Zipkin
* Honeycomb
* Lightstep
Cloud Native
* Kubernetes
* OpenTelemetry Collector
* Grafana Stack
핵심 메시지
“측정할 수 없으면 개선할 수 없고, 관찰할 수 없으면 신뢰할 수 없습니다.”
AI 시스템과 클라우드 환경의 경쟁력은 더 이상 단순히 좋은 모델이 아니라, 시스템 내부를 얼마나 정확하게 관찰하고 이해하며 지속적으로 개선할 수 있는가에 달려 있습니다.
로그(Logging) 는 무엇이 발생했는지를 기록하고, 트레이싱(Tracing) 은 왜 발생했는지를 추적하며, 메트릭(Metrics) 은 현재 시스템이 얼마나 건강한지를 측정합니다.
세 가지가 하나로 연결될 때 비로소 진정한 Observability 가 완성되며, 이는 안정적인 AI 서비스와 클라우드 운영을 위한 가장 강력한 기반이 됩니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)