
‘생각해야 할 양을 줄이는 것’입니다.
많은 사람들이 AI 성능을 높이기 위해 더 큰 GPU와 더 많은 메모리, 더 거대한 LLM만을 고민합니다. 하지만
실제 엔터프라이즈 AI 시스템에서는 ‘무엇을 얼마나 적게 생각하게 만들 것인가’가 성능과 비용을 결정하는 핵심 요소입니다.
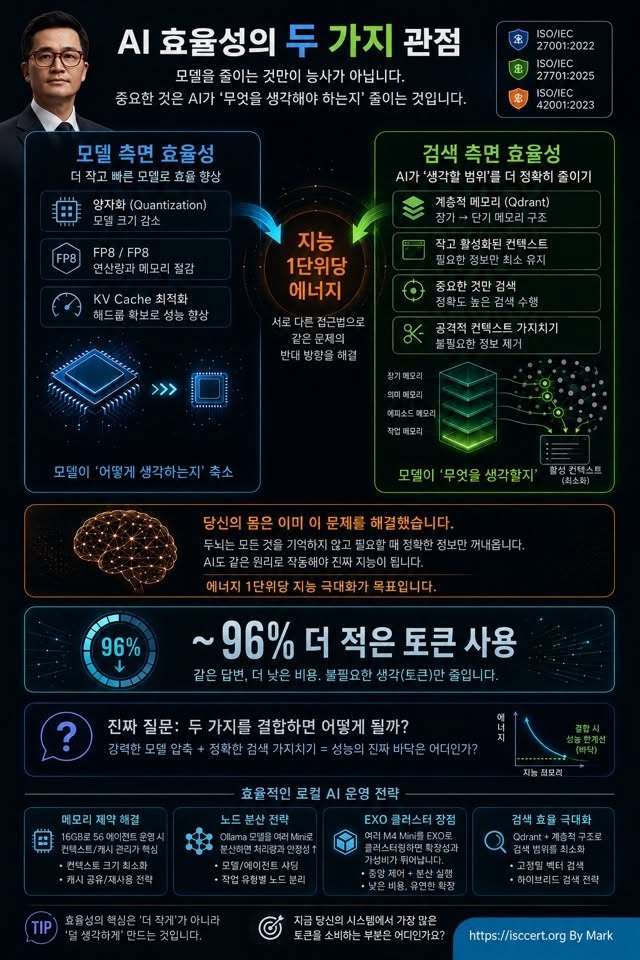
AI 효율성은 크게 두 가지 전략이 함께 작동할 때 극대화됩니다.
① 모델 측면 효율성(Model-Side Efficiency)
모델 자체를 더 작고 빠르게 만드는 접근입니다.
대표 기술은 다음과 같습니다.
Quantization(양자화)
FP16, FP8, INT8 등으로 모델 크기를 줄여 메모리 사용량과 추론 비용을 크게 절감합니다.
FP8 연산 최적화
최신 AI 가속기에서 연산 속도는 높이고 전력 소비는 낮춰 대규모 추론에 적합합니다.
KV Cache 최적화
대화 중 생성된 토큰을 재사용하여 중복 계산을 줄이고 응답 속도를 향상시킵니다.
핵심 목표는 모델이 더 적은 자원으로 더 빠르게 사고하도록 만드는 것입니다.
② 검색·컨텍스트 측면 효율성(Retrieval-Side Efficiency)
진정한 AI 효율성은 모델 크기보다 컨텍스트 관리에서 시작됩니다.
AI가 모든 문서를 읽는 것이 아니라 필요한 정보만 정확하게 가져오도록 설계해야 합니다.
대표 전략은 다음과 같습니다.
계층형 메모리(Hierarchical Memory)
* 장기 기억(Long-term Memory)
* 의미 기억(Semantic Memory)
* 에피소드 기억(Episodic Memory)
* 작업 기억(Working Memory)
필요한 순간에 필요한 정보만 활성화합니다.
Tiny Active Context
항상 작은 컨텍스트만 유지합니다.
모든 문서를 프롬프트에 넣는 것이 아니라 현재 작업과 직접 관련된 정보만 전달하여 토큰 사용량과 추론 비용을 줄입니다.
필요한 정보만 검색
Vector Search(Qdrant 등)와 RAG를 활용하여 질문과 가장 관련성이 높은 정보만 검색합니다.
검색 정확도가 높을수록 AI의 답변 품질도 함께 향상됩니다.
컨텍스트 가지치기(Context Pruning)
불필요한 문서와 오래된 대화, 중복 정보를 제거하여 모델이 정말 중요한 정보에만 집중하도록 만듭니다.
핵심 개념 : 지능 1단위당 에너지(Energy per Unit of Intelligence)
효율적인 AI는 더 많은 연산을 하는 것이 아니라 같은 결과를 더 적은 연산과 전력으로 만들어내는 시스템입니다.
사람의 뇌도 모든 정보를 항상 기억하지 않습니다.
필요할 때 필요한 기억만 떠올리듯, AI도 검색(Retrieval)과 메모리 관리(Memory Management)를 통해 필요한 정보만 활용해야 합니다.
이것이 차세대 AI 아키텍처의 핵심 철학입니다.
최대 96% 토큰 절감도 가능
컨텍스트 최적화와 검색 효율화를 적용하면
* 불필요한 토큰 감소
* GPU 메모리 절약
* 추론 속도 향상
* API 비용 절감
을 동시에 달성할 수 있습니다.
같은 품질의 답변을 더 적은 비용으로 생성하는 것이 진정한 AI 최적화입니다.
로컬 AI 운영자를 위한 실전 전략
메모리 병목 해결
Mac mini M4 16GB와 같은 환경에서는 모델보다 컨텍스트와 KV Cache 관리가 더 중요합니다.
* 컨텍스트 최소화
* 캐시 재사용
* 메모리 누수 방지
* 작업 단위 분리
분산 추론(Distributed Inference)
여러 대의 장비를 연결하면
* 모델 분산
* 에이전트 분산
* 역할 기반 노드 구성
을 통해 처리량과 안정성을 높일 수 있습니다.
EXO 클러스터 활용
여러 대의 Mac mini를 EXO로 클러스터링하면
* 메모리 확장
* 추론 성능 향상
* 비용 대비 높은 효율
* 유연한 확장성
을 기대할 수 있습니다.
검색 효율 극대화
Qdrant와 같은 벡터 데이터베이스를 활용하면
* 검색 정확도 향상
* 활성 컨텍스트 최소화
* 하이브리드 검색
* 의미 기반 검색
을 통해 AI가 필요한 정보만 빠르게 활용할 수 있습니다.
결론
AI 성능을 높이는 가장 좋은 방법은 더 큰 모델을 사용하는 것이 아닙니다.
더 작은 모델 + 더 정확한 검색 + 더 효율적인 메모리 관리 + 더 작은 활성 컨텍스트를 결합하면 비용은 낮추고 성능은 높일 수 있습니다.
미래의 AI 경쟁력은 GPU 개수가 아니라 컨텍스트를 얼마나 효율적으로 관리하느냐에 달려 있습니다.
“최고의 AI는 가장 많이 생각하는 AI가 아니라, 가장 필요한 것만 생각하는 AI입니다.”
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)