
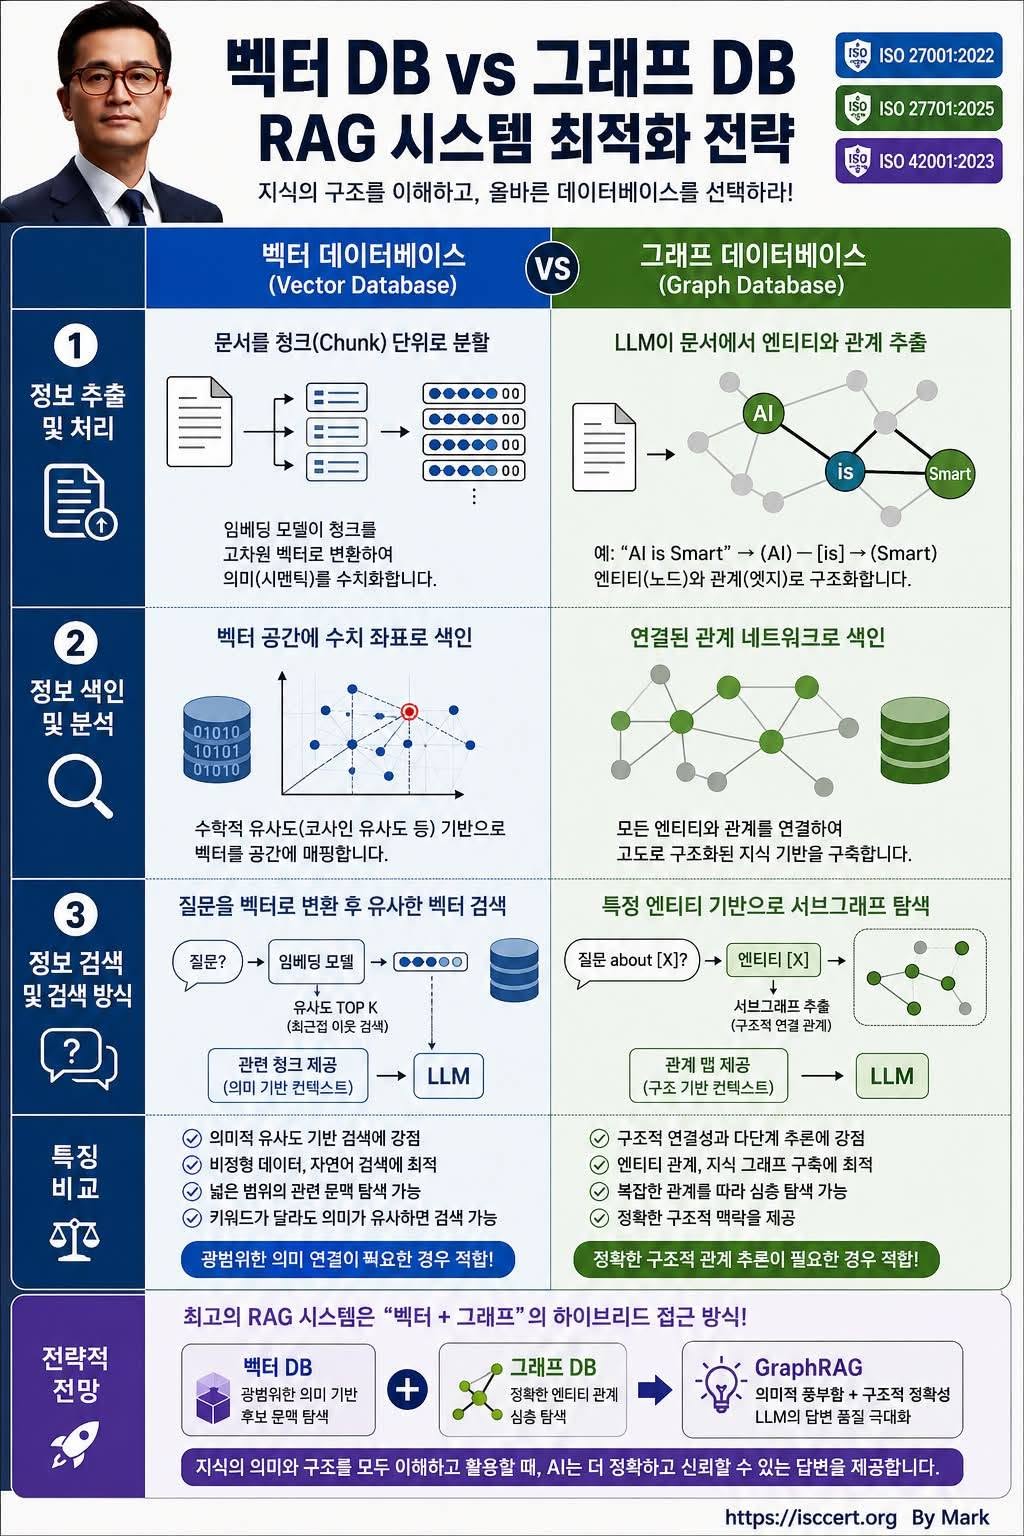
vs 그래프 데이터베이스(Graph DB)
RAG(Retrieval-Augmented Generation) 시스템, 어떤 데이터베이스를 선택해야 할까?
AI의 성능은 모델만으로 결정되지 않습니다. 어떤 방식으로 지식을 저장하고 검색하는지가
생성 결과의 정확도와 신뢰성을 크게 좌우합니다.
벡터 데이터베이스와 그래프 데이터베이스는 서로 경쟁하는 기술이 아니라
각기 다른 문제를 해결하는 핵심 기술입니다.
1. 정보 추출(Information Extraction)
벡터 데이터베이스 (Vector Database)
문서의 의미(Semantics)를 이해하는 방식
* 문서를 일정 크기의 청크(Chunk) 로 분할
* 임베딩(Embedding) 모델이 각 청크를 고차원 벡터(Vector) 로 변환
* 문장의 의미를 숫자로 표현하여 저장
* 자연어의 의미적 유사성을 계산하는 데 최적
활용 사례
* ChatGPT 기업 문서 검색
* FAQ 검색
* 매뉴얼 검색
* 논문 검색
* 고객 상담 AI
그래프 데이터베이스 (Graph Database)
문서 속 관계(Relationship)를 이해하는 방식
LLM이 문장을 분석하여
AI → is → Smart
처럼
* 엔티티(Entity)
* 관계(Relationship)
를 추출하고
이를
노드(Node)와 엣지(Edge) 형태의 지식 그래프로 저장합니다.
활용 사례
* Knowledge Graph
* 의료 지식
* 금융 관계 분석
* 사이버 공격 경로
* 조직도 분석
2. 정보 저장 및 인덱싱(Information Indexing)
Vector Database
저장 방식
문서
↓
Chunk
↓
Embedding
↓
Vector Space
특징
의미 기반 검색
코사인 유사도 검색
ANN(Approximate Nearest Neighbor)
빠른 대용량 검색
대표 제품
* Pinecone
* Milvus
* Weaviate
* Qdrant
* ChromaDB
Graph Database
저장 방식
문서
↓
Entity 추출
↓
Relationship 생성
↓
Knowledge Graph
특징
관계 중심 저장
연결성 분석
다단계 탐색(Multi-hop)
복잡한 추론
대표 제품
* Neo4j
* TigerGraph
* Amazon Neptune
* Memgraph
* ArangoDB
3. 검색 방식(Retrieval)
Vector DB
사용자 질문
↓
Embedding 생성
↓
가장 가까운 벡터 검색
↓
관련 문서 반환
↓
LLM 응답 생성
강점
의미가 비슷하면 검색 가능
키워드가 달라도 검색 가능
비정형 데이터에 강함
자연어 질문에 최적
Graph DB
사용자 질문
↓
엔티티 식별
↓
관련 노드 탐색
↓
Subgraph 추출
↓
LLM 응답 생성
강점
관계 기반 추론
Multi-Hop Reasoning
인과관계 분석
연결 구조 설명 가능
언제 어떤 DB를 선택해야 할까?
Vector Database 추천
다음과 같은 경우 가장 적합합니다.
사내 문서 검색
PDF 검색
기술 문서
FAQ
고객 상담
논문 검색
자연어 검색
Graph Database 추천
다음과 같은 경우 강력한 성능을 제공합니다.
기업 조직도
ISO 관리체계
법률 규정
개인정보 흐름
공급망 분석
금융 관계 분석
공격 경로 분석
AI Agent 간 관계 추론
ISO/IEC 27001 자동심사 사례
예를 들어,
ISO/IEC 27001 자동심사 Agent에서는
Vector DB가 담당하는 역할
* 정책 문서 검색
* 절차서 검색
* 증적 검색
* 심사 사례 검색
* 유사 부적합 사례 검색
Graph DB가 담당하는 역할
다음 관계를 모두 연결합니다.
조항
↓
통제(Control)
↓
리스크
↓
증적
↓
담당자
↓
시정조치
↓
심사결과
이러한 연결을 통해
“A.8.15 로그 모니터링 통제가 미흡하면 어떤 리스크가 발생하며, 관련 증적과 시정조치는 무엇인가?”
와 같은 다단계(Multi-hop) 질의를 빠르고 정확하게 수행할 수 있습니다.
차세대 RAG는 GraphRAG
최근 엔터프라이즈 AI는 Vector DB와 Graph DB를 함께 사용하는 하이브리드(GraphRAG) 구조로 빠르게 진화하고 있습니다.
① Vector DB
* 의미가 유사한 문서를 신속하게 탐색
* 광범위한 관련 정보를 확보
② Graph DB
* 엔티티 간 관계를 추적
* 원인·영향·연결 구조를 분석
③ LLM
* 두 데이터베이스에서 제공한 정보를 종합하여
* 더욱 정확하고 설명 가능한(Explainable) 답변 생성
핵심 한 줄 정리
Vector Database는 “의미(Semantics)“를 검색하고, Graph Database는 “관계(Relationship)“를 추론합니다. 최고의 RAG 시스템은 두 기술을 결합한 GraphRAG 아키텍처에서 탄생합니다.
AI 시대의 경쟁력은 더 이상 좋은 LLM을 사용하는 것에만 있지 않습니다.
어떻게 지식을 저장하고(Retrieval),
연결하며(Relationship), 활용하는지(Knowledge Engineering)가
AI의 품질을 결정합니다.
특히 기업형 RAG,
AI Agent, ISO 자동심사,
지식관리(KMS), 법률·의료·금융 AI와 같은
고신뢰 시스템에서는 Vector DB와
Graph DB를 결합한 GraphRAG가
새로운 표준으로 자리 잡고 있습니다.
“의미를 찾는 AI(Vector)와 관계를 이해하는 AI(Graph)가 함께할 때,
AI는 더욱 정확하고 신뢰할 수 있는 의사결정을 지원합니다.”
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)