
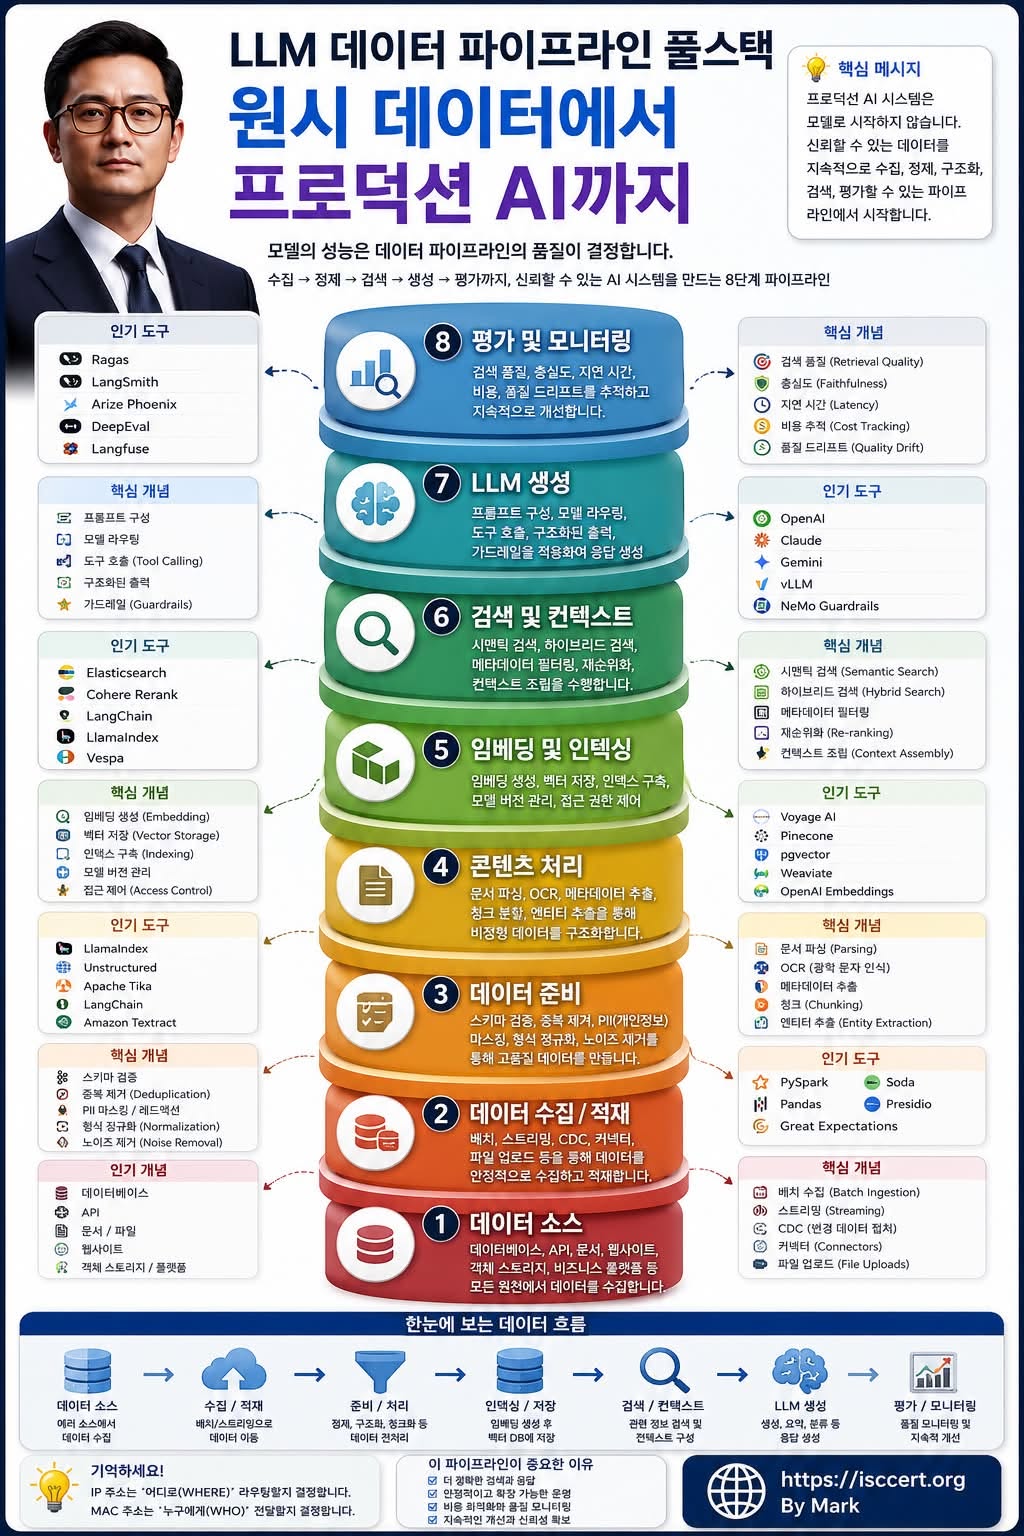
원시 데이터(Raw Data)에서 프로덕션 AI(Production AI)까지,
AI 성공을 결정하는 8단계
많은 사람들이 AI 시스템의 성능은 어떤 LLM(대규모 언어모델)을 선택하느냐에 달려 있다고 생각합니다.
하지만 실제 프로덕션 환경에서는
모델보다 데이터 파이프라인(Data Pipeline)의 품질이 AI 성능을 결정하는 경우가
훨씬 많습니다.
아무리 뛰어난 LLM이라도 부정확하거나
오래된 데이터, 잘못된 검색,
부족한 평가 체계를 사용하면 신뢰할 수 있는 결과를 만들 수 없습니다.
강력한 AI 시스템은 모델이 아니라, 신뢰할 수 있는 데이터를 수집·가공·검색·생성·평가하는
데이터 파이프라인에서 시작됩니다.
LLM 데이터 파이프라인 8단계
① 데이터 소스 (Data Sources)
모든 AI의 시작은 양질의 데이터 확보입니다.
대표 데이터 소스
* 데이터베이스(PostgreSQL, MongoDB)
* REST API
* 문서(PDF, Word, Excel)
* 웹사이트
* 객체 스토리지(Amazon S3 등)
* CRM·ERP·업무 시스템
핵심 포인트
AI는 입력 데이터의 품질을 절대 뛰어넘을 수 없습니다.
② 데이터 수집 (Data Ingestion)
여러 시스템에 흩어진 데이터를 안정적으로 수집합니다.
대표 방식
* Batch 처리
* Streaming
* CDC(Change Data Capture)
* Connector
* File Upload
대표 도구
* Apache Kafka
* Apache NiFi
* Airbyte
* Fivetran
* Debezium
③ 데이터 준비 (Data Preparation)
수집한 데이터를 AI가 이해할 수 있도록 정제합니다.
주요 작업
스키마 검증
중복 제거
개인정보(PII) 마스킹
데이터 정규화
노이즈 제거
Garbage In, Garbage Out(GIGO) 원칙처럼 데이터 품질이 AI 결과를 좌우합니다.
④ 콘텐츠 처리 (Content Processing)
비정형 데이터를 AI가 이해할 수 있는 구조로 변환합니다.
주요 작업
* 문서 파싱
* OCR
* 메타데이터 추출
* Chunking
* Entity Extraction
대표 도구
* Apache Tika
* Unstructured
* Amazon Textract
* LangChain
⑤ 임베딩 및 인덱싱 (Embedding & Indexing)
텍스트를 벡터(Vector)로 변환하여 의미 기반 검색이 가능하도록 합니다.
핵심 기술
* Embedding 생성
* Vector Database 저장
* Index 생성
* Access Control
* Version 관리
대표 도구
* Pinecone
* Weaviate
* pgvector
* Voyage AI
* OpenAI Embeddings
⑥ 검색 및 컨텍스트 구성 (Retrieval & Context)
RAG(Retrieval-Augmented Generation)의 핵심 단계입니다.
주요 기능
의미 기반 검색(Semantic Search)
하이브리드 검색(Hybrid Search)
메타데이터 필터링
Re-ranking
Context Assembly
좋은 검색 품질은 LLM의 답변 품질을 결정하는 가장 중요한 요소입니다.
⑦ LLM 생성 (LLM Generation)
검색된 정보를 기반으로 실제 답변을 생성합니다.
주요 기술
* Prompt Engineering
* Model Routing
* Tool Calling
* Structured Output
* Guardrails
대표 모델
* OpenAI GPT
* Claude
* Gemini
* vLLM
* NVIDIA NeMo Guardrails
⑧ 평가 및 모니터링 (Evaluation & Monitoring)
AI 운영은 배포로 끝나지 않습니다.
지속적으로 성능을 측정하고 개선해야 합니다.
평가 항목
* Retrieval Quality
* Faithfulness(사실성)
* Latency(응답 시간)
* Cost Tracking
* Quality Drift
대표 도구
* LangSmith
* Langfuse
* Ragas
* Arize Phoenix
* DeepEval
AI 엔지니어가 반드시 기억해야 할 핵심
AI 시스템의 성능은 다음 공식으로 이해할 수 있습니다.
AI 품질 = 데이터 품질 × 검색 품질 × 모델 품질 × 지속적인 평가
즉, 최신 LLM을 사용하는 것보다 신뢰할 수 있는 데이터 파이프라인을 구축하는 것이 훨씬 중요합니다.
실무에서 많이 사용하는 기술 스택
데이터 수집
* Kafka
* Airbyte
* NiFi
↓
데이터 처리
* Pandas
* PySpark
* Great Expectations
↓
문서 처리
* Unstructured
* Apache Tika
* LangChain
↓
Vector DB
* Pinecone
* Weaviate
* pgvector
↓
LLM
* GPT
* Claude
* Gemini
↓
평가
* LangSmith
* Langfuse
* Ragas
핵심 메시지
AI 프로젝트의 성공은 LLM 자체보다 데이터 파이프라인의 완성도에 달려 있습니다.
데이터를 수집(Collect) → 정제(Clean) → 구조화(Structure) → 검색(Retrieve) → 생성(Generate) → 평가(Evaluate) 하는 전 과정을 체계적으로 설계해야만 정확하고 신뢰할 수 있는 프로덕션 AI 시스템을 구축할 수 있습니다.
앞으로의 AI 경쟁력은 더 큰 모델을 사용하는 것이 아니라, 더 나은 데이터 파이프라인과 RAG 아키텍처를 구축하는 능력에서 결정될 것입니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)