
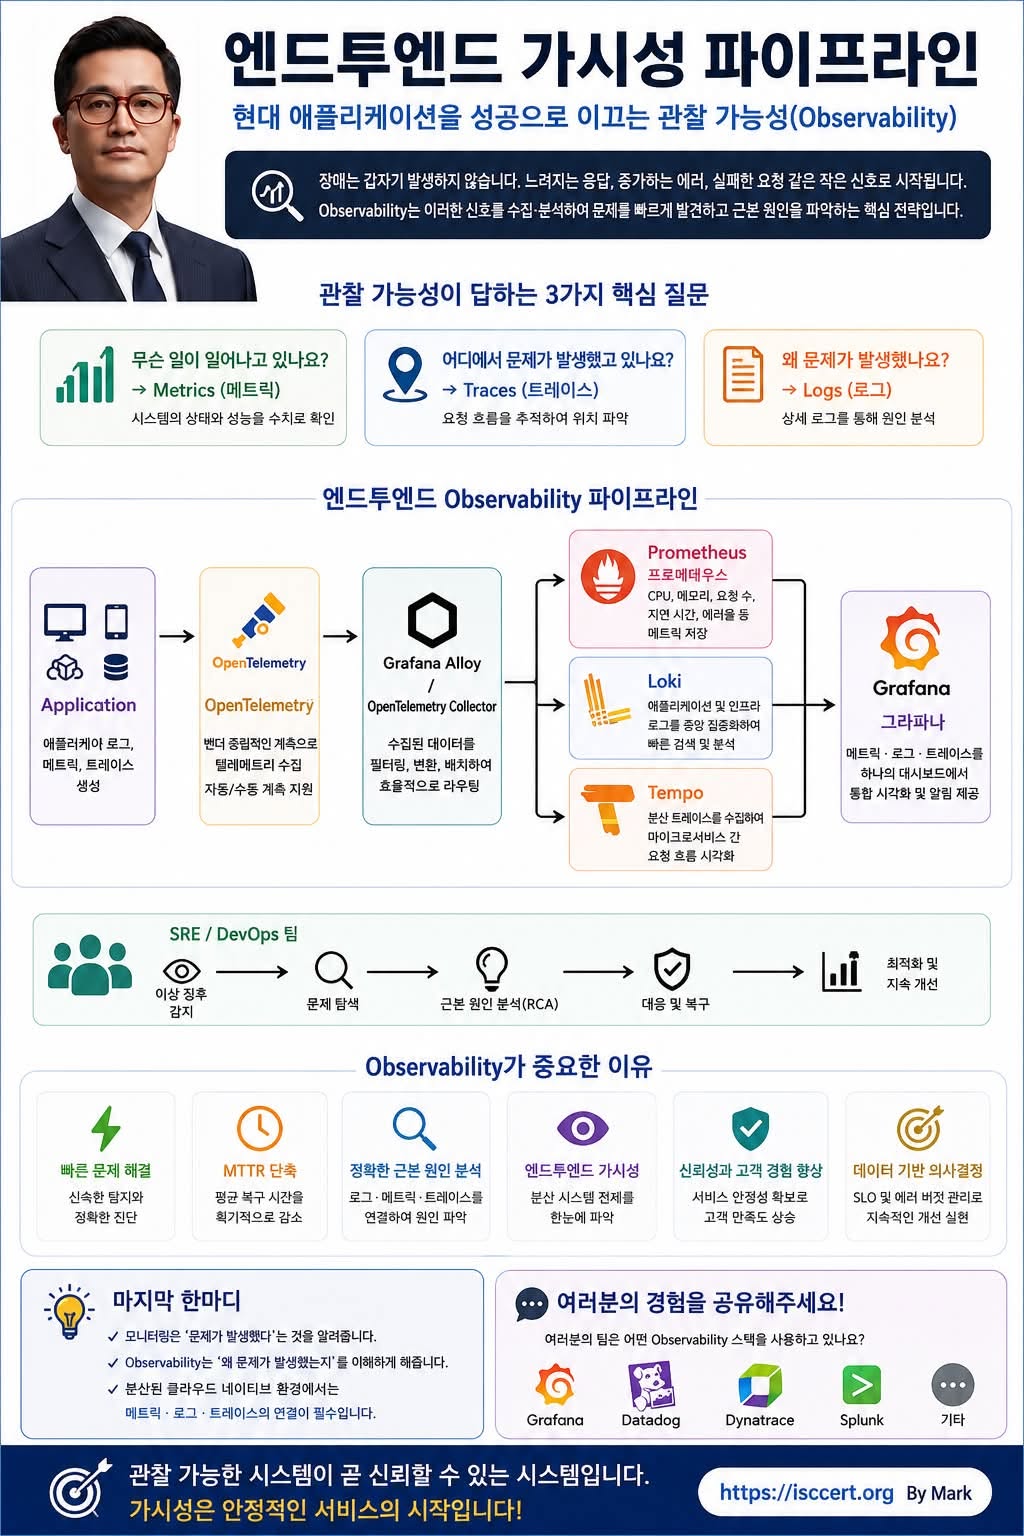
현대 애플리케이션을 위한 엔드투엔드(End-to-End) 가시성(Observability)
오늘날 대부분의 장애는 갑작스러운 시스템 다운으로 시작되지 않습니다.
오히려 응답 속도 증가(Latency), 오류율 상승(Error Rate), 실패한 요청(Request Failure) 과 같은 작은 이상 징후에서 시작됩니다.
그래서 최신 DevOps와 SRE 조직은 단순한 모니터링(Monitoring) 을 넘어 관찰 가능성(Observability) 을 구축합니다.
Observability가 답하는 3가지 핵심 질문
무슨 일이 일어나고 있는가?
→ Metrics(메트릭)
CPU, 메모리, 요청 수, 지연시간, 에러율 등 시스템의 현재 상태를 실시간으로 수치화합니다.
문제는 어디에서 발생했는가?
→ Traces(트레이스)
사용자의 요청(Request)이 여러 마이크로서비스를 거치는 전체 경로를 추적하여 병목과 장애 위치를 빠르게 찾아냅니다.
왜 문제가 발생했는가?
→ Logs(로그)
애플리케이션과 인프라에서 생성된 상세 로그를 분석하여 근본 원인(RCA)을 확인합니다.
End-to-End Observability Pipeline
① Application
애플리케이션이 로그(Log), 메트릭(Metrics), 트레이스(Trace) 를 생성합니다.
↓
② OpenTelemetry
벤더에 종속되지 않는(Open Standard) 방식으로 텔레메트리 데이터를 자동 또는 수동으로 수집합니다.
↓
③ Grafana Alloy / OpenTelemetry Collector
수집된 데이터를
필터링
변환
배치 처리
라우팅
하여 저장소로 전달합니다.
↓
④ Prometheus
CPU, Memory, Latency, Error Rate 등 메트릭 데이터를 저장하고 분석합니다.
↓
⑤ Loki
애플리케이션과 인프라 로그를 중앙에서 통합 관리하여 장애 분석 시간을 크게 단축합니다.
↓
⑥ Tempo
분산 트레이싱을 통해 마이크로서비스 간 요청 흐름을 시각화합니다.
↓
⑦ Grafana
Metrics · Logs · Traces를 하나의 대시보드에서 통합하여
실시간 모니터링
Alert
Dashboard
RCA
SLI/SLO
Error Budget
을 효과적으로 관리합니다.
SRE / DevOps 팀의 운영 프로세스
이상 징후 감지
문제 조사
근본 원인 분석(RCA)
장애 대응
서비스 복구
성능 최적화 및 지속적 개선
Observability가 중요한 이유
장애 대응 시간(MTTR) 단축
정확한 Root Cause Analysis(RCA)
데이터 기반 의사결정
분산 시스템의 End-to-End 가시성 확보
서비스 안정성 및 성능 향상
고객 만족도와 사용자 경험(UX) 개선
SLO·SLI·Error Budget 기반 운영 체계 구축
Monitoring과 Observability의 차이
Monitoring
“문제가 발생했습니다.”
→ 이상 여부를 알려줍니다.
Observability
“왜 문제가 발생했는지, 어디에서 시작되었는지, 어떻게 해결해야 하는지”
→ 근본 원인까지 분석할 수 있도록 도와줍니다.
즉,
Monitoring은 ’무엇(What)’을 알려주고,
Observability는 ’왜(Why)’와 ’어떻게(How)’를 설명합니다.
클라우드 네이티브 시대의 필수 역량
Kubernetes, Microservices, Cloud Native 환경에서는
Metrics + Logs + Traces 를 서로 연계하여 분석하는 것이 더 이상 선택이 아닌 필수입니다.
이 세 가지 데이터를 통합적으로 활용할 때 장애를 빠르게 해결하고, 더욱 안정적인 서비스를 제공할 수 있습니다.
여러분은 어떤 Observability Stack을 사용하고 계신가요?
Grafana
OpenTelemetry
Prometheus
Loki
Tempo
Datadog
Dynatrace
Splunk
Elastic Stack
또는 다른 솔루션을 사용하고 계신다면 댓글로 함께 공유해주세요!
한 줄 메시지
“모니터링은 장애를 알려주지만, Observability는 장애의 원인을 밝혀줍니다.”
“관찰 가능한 시스템이 곧 안정적이고 신뢰할 수 있는 시스템입니다.”
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)