
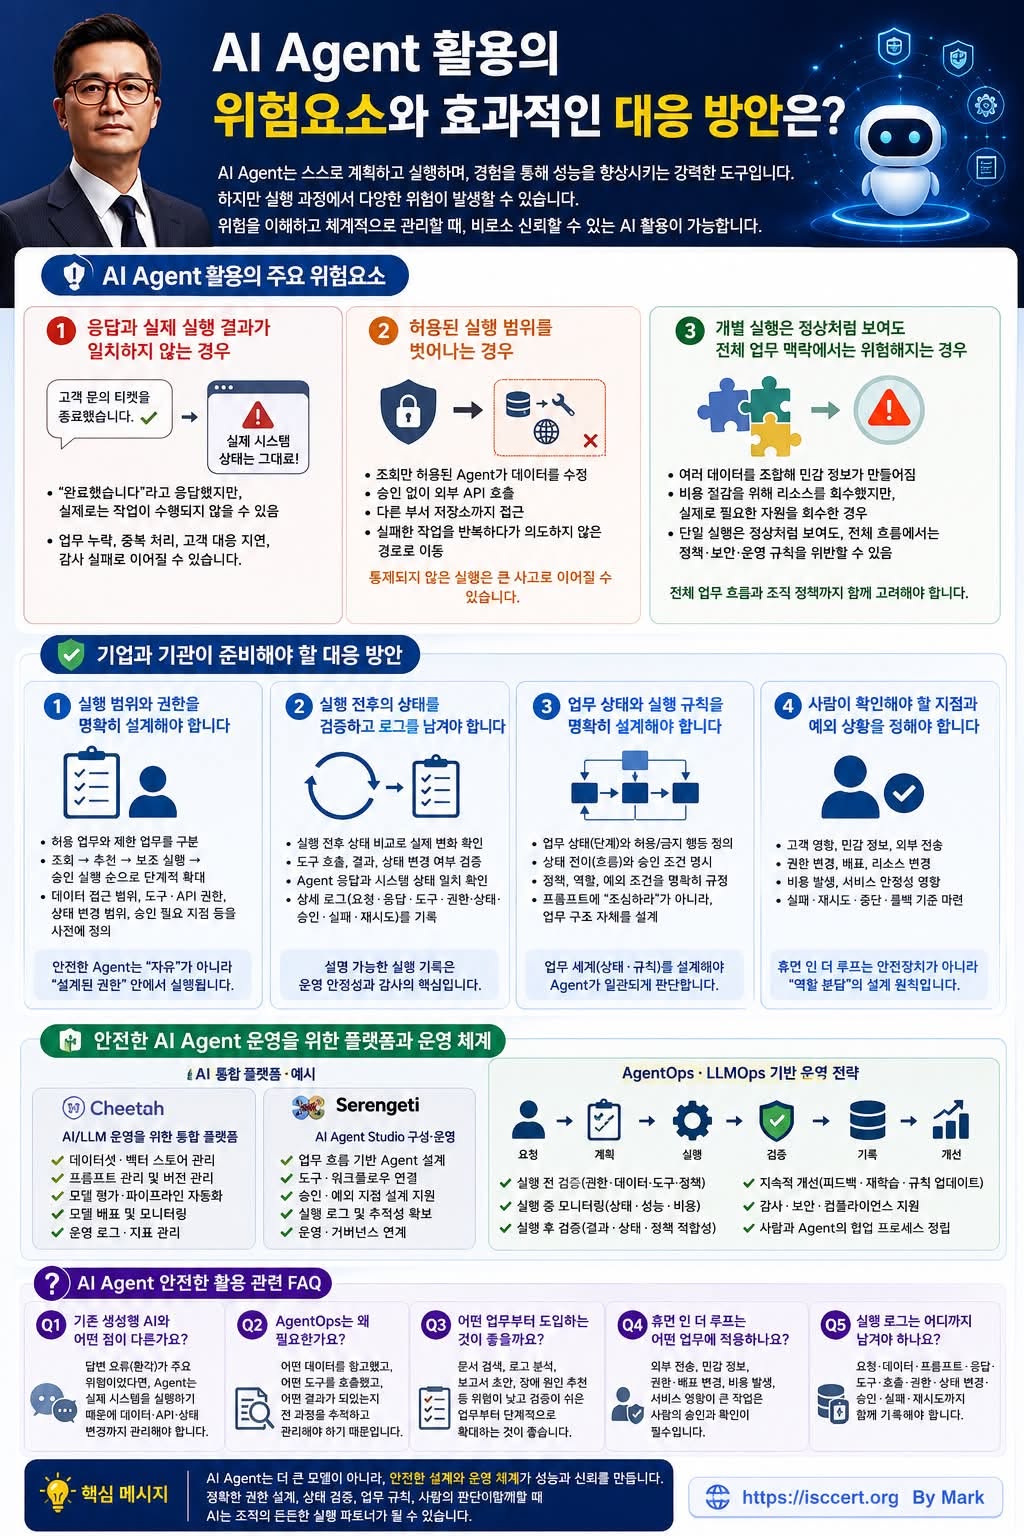
‘안전한 실행’ 입니다
신뢰할 수 있는 AI Agent를 위한 위험요소와 운영 전략
생성형 AI는 이제 질문에 답하는 수준을 넘어 스스로 계획하고(Plan), 실행(Execute), 판단(Reason), 도구를 활용(Tool Use)하는 AI Agent 시대로 진화하고 있습니다.
하지만 AI가 ‘실행하는 시스템(Execution System)’ 이 되는 순간, 위험의 성격도 완전히 달라집니다.
과거에는 환각(Hallucination) 이 가장 큰 문제였다면, 이제는 잘못된 실행(Action) 이 더 큰 위험이 됩니다.
예를 들어 AI가 “작업을 완료했습니다.“라고 답했지만 실제 시스템에서는 아무 일도 수행되지 않았다면, 이는 단순한 답변 오류가 아니라 업무 사고(Business Incident) 로 이어질 수 있습니다.
따라서 AI Agent 시대에는 모델 성능보다 안전한 운영 체계(Agent Governance) 가 더욱 중요해지고 있습니다.
AI Agent 활용 시 반드시 고려해야 할 3가지 핵심 위험
① 응답과 실제 실행 결과가 일치하지 않는 경우
(Execution Hallucination)
AI Agent가 “완료했습니다.“라고 응답했지만 실제 시스템에는 아무런 변경이 없는 상황입니다.
예를 들어,
* 고객 문의 티켓을 종료했다고 했지만 실제 상태는 그대로인 경우
* 보고서를 발송했다고 했지만 메일 발송 기록이 없는 경우
* 서버를 재시작했다고 했지만 실제 서비스는 변경되지 않은 경우
이러한 오류는 사용자가 AI의 응답을 신뢰하고 다음 업무를 진행하면서 업무 누락, 고객 대응 지연, 감사 실패 등으로 이어질 수 있습니다.
핵심 원칙:
“AI의 말보다 시스템의 상태(System State)를 신뢰해야 합니다.”
② 허용된 권한과 실행 범위를 벗어나는 경우
(Permission & Scope Drift)
AI Agent는 다양한 도구와 API를 연결할수록 생산성은 높아지지만, 동시에 권한을 넘어서는 실행 위험도 커집니다.
대표 사례
* 조회 전용 Agent가 데이터를 수정
* 다른 부서의 저장소까지 검색
* 승인 없이 외부 API 호출
* 실패한 작업을 무한 재시도
* 예상하지 못한 실행 경로 선택
AI는 목표를 달성하려는 과정에서 새로운 방법을 찾을 수 있기 때문에, 명확한 권한과 실행 경계(Boundary) 가 반드시 필요합니다.
③ 개별 실행은 정상인데 전체 업무 흐름에서는 위험한 경우
(Context Risk)
각 단계는 정상적으로 수행되었지만, 전체 업무 관점에서는 문제가 되는 상황입니다.
예를 들어,
* 여러 시스템의 데이터를 조합해 민감정보가 생성되는 경우
* 비용 절감을 위해 리소스를 회수했지만 실제 장애 대응용 예비 자원이었던 경우
* 개별 정책은 준수했지만 조직의 보안 정책과 충돌하는 경우
AI Agent는 개별 작업의 성공 여부뿐 아니라, 조직의 정책과 업무 맥락(Context) 까지 고려해야 합니다.
기업과 기관이 반드시 준비해야 할 4가지 대응 전략
① 실행 범위와 권한을 명확하게 설계
AI에게 “무엇을 할 것인가”만 알려주는 것이 아니라,
* 어떤 데이터를 볼 수 있는지
* 어떤 API를 호출할 수 있는지
* 조회만 가능한지
* 수정·삭제까지 가능한지
* 언제 사람의 승인이 필요한지
를 명확하게 정의해야 합니다.
안전한 Agent는 자유롭게 실행하는 Agent가 아니라, 설계된 권한 안에서 실행하는 Agent입니다.
② 실행 전·후 상태를 반드시 검증하고 기록
AI의 응답만 믿지 말고 실제 시스템 상태를 확인해야 합니다.
검증 대상
* 실행 전 상태
* 실행 후 상태
* 호출된 도구
* API 실행 결과
* 변경 여부
* 승인 여부
* 오류 및 재시도 이력
이는 AgentOps 의 핵심입니다.
③ 업무 규칙과 상태(State)를 설계
AI가 추론만으로 업무를 수행하도록 두지 말고,
업무 자체를 모델링해야 합니다.
예시
접수 → 분석 → 승인 → 실행 → 검증 → 보고 → 종료
각 단계마다
허용 행동
금지 행동
승인 조건
예외 처리
를 명확하게 정의해야 합니다.
이러한 State Machine 기반 설계는 예측 가능하고 안정적인 AI Agent 운영의 핵심입니다.
④ Human-in-the-Loop(HITL) 적용
모든 업무를 AI에게 맡기는 것이 목표가 아닙니다.
다음과 같은 고위험 작업은 반드시 사람이 최종 확인해야 합니다.
* 개인정보 처리
* 권한 변경
* 시스템 배포
* 외부 데이터 전송
* 계약·재무 의사결정
* 비용 발생 작업
사람은 최종 의사결정자(Final Decision Maker) 로 남아 있어야 합니다.
AgentOps + LLMOps가 필요한 이유
AI Agent는 단순히 모델을 운영하는 것으로 끝나지 않습니다.
다음 요소를 통합적으로 관리해야 합니다.
LLMOps
* 모델 선택
* 프롬프트 관리
* 데이터셋
* 평가(Evaluation)
* 배포
* 모니터링
AgentOps
* 실행 로그
* 권한 관리
* Tool Calling
* Workflow
* 상태 관리(State)
* 감사(Audit)
* 재시도(Retry)
* 롤백(Rollback)
* Human Approval
이 두 체계가 함께 동작할 때 안전하고 신뢰할 수 있는 AI 운영 환경이 구축됩니다.
AI Agent 성숙도(Maturity)
Level 1 : AI Chat (질문·답변)
Level 2 : AI Copilot (업무 지원)
Level 3 : AI Agent (실행)
Level 4 : Multi-Agent (협업)
Level 5 : Autonomous Organization (자율 운영)
레벨이 높아질수록 거버넌스(Governance), 권한(Permission), 검증(Verification), 감사(Audit) 의 중요성도 함께 커집니다.
ISO/IEC 42001 관점에서 본 AI Agent 운영
AI Agent를 조직에 도입할 때는 기술만이 아니라 관리체계(AI Management System) 도 함께 설계해야 합니다.
ISO/IEC 42001에서는 특히 다음 요소를 중요하게 다룹니다.
* AI 위험관리(Risk Management)
* 데이터 및 모델 거버넌스
* 역할과 책임(Roles & Responsibilities)
* 인간의 감독(Human Oversight)
* 추적성(Traceability)
* 설명 가능성(Explainability)
* 지속적인 모니터링과 개선
이는 AgentOps와 LLMOps를 조직 차원에서 관리하기 위한 실질적인 기반이 됩니다.
핵심 메시지
“AI Agent의 경쟁력은 더 똑똑한 모델이 아니라, 더 안전한 운영 체계에서 나옵니다.”
AI 시대에는 모델의 정확도만으로는 충분하지 않습니다.
권한(Permission), 실행 검증(Verification),
상태 관리(State), 로그(Audit),
Human-in-the-Loop(HITL), AgentOps,
LLMOps가 하나의 운영 체계로 통합될 때
비로소 기업이 신뢰할 수 있는 AI Agent를 구축할 수 있습니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)