
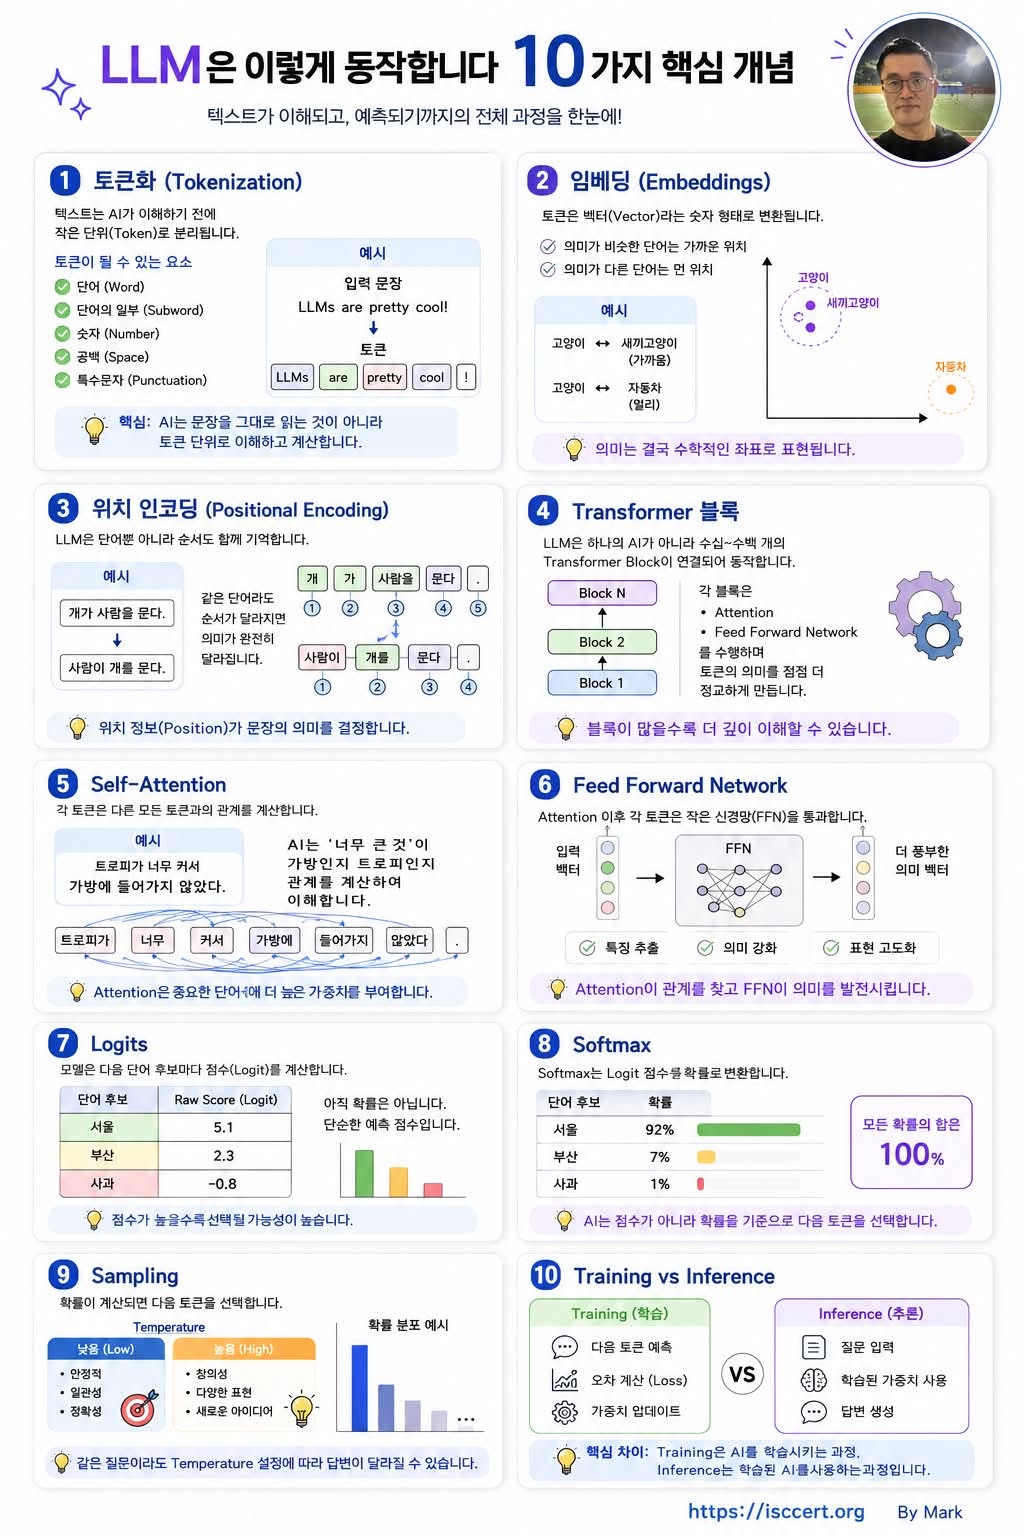
ChatGPT와 Claude 같은 “대규모 언어모델(LLM)”은 단순히 문장을 외우는 것이 아닙니다. 입력된 문장을 분석 → 이해 → 예측 → 생성하는 과정을 수십~수백 개의 Transformer Layer에서 반복하며 가장 자연스러운 다음 단어를 만들어냅니다.
① 토큰화 (Tokenization)
AI는 문장을 작은 조각으로 나눠 이해합니다.
사람은 문장을 한 번에 읽지만 AI는 먼저 문장을 토큰(Token) 이라는 작은 단위로 분리합니다.
토큰은 다음과 같은 형태가 될 수 있습니다.
단어(Word)
단어 일부(Subword)
숫자(Number)
공백(Space)
특수문자(Punctuation)
예시
“LLMs are pretty cool!”
↓
LLMs | are | pretty | cool | !
핵심
AI는 문장을 그대로 읽는 것이 아니라 토큰 단위로 계산하고 이해합니다.
② 임베딩 (Embeddings)
의미를 숫자(벡터)로 변환합니다.
AI는 글자를 이해하지 못합니다.
대신 모든 토큰을 수백~수천 개의 숫자로 이루어진 벡터(Vector) 로 변환합니다.
의미가 비슷한 단어는 벡터 공간에서도 가까운 위치에 존재합니다.
예시
고양이 새끼고양이 (가까움)
자동차 자전거 (중간)
고양이 비행기 (멀리)
핵심
AI에게 의미란 결국 수학적인 좌표입니다.
③ 위치 인코딩 (Positional Encoding)
단어의 순서까지 함께 기억합니다.
같은 단어라도 순서가 달라지면 의미는 완전히 달라집니다.
예시
개가 사람을 문다.
사람이 개를 문다.
사용된 단어는 같지만 의미는 정반대입니다.
그래서 AI는 각 토큰에 위치 정보(Position) 를 함께 저장합니다.
핵심
단어뿐 아니라 순서까지 이해해야 문맥을 올바르게 파악할 수 있습니다.
④ Transformer 블록
AI의 핵심 엔진
LLM은 하나의 거대한 계산기가 아니라
수십~수백 개의 Transformer Block이 연결된 구조입니다.
각 블록은
Attention
Feed Forward Network
두 과정을 반복하며
문장의 의미를 점점 더 정교하게 만듭니다.
핵심
블록이 많을수록 복잡한 문맥도 이해할 수 있습니다.
⑤ Self-Attention
중요한 단어를 찾아 집중합니다.
모든 단어가 동일하게 중요한 것은 아닙니다.
AI는 문장을 읽으면서
“어떤 단어가 지금 가장 중요한가?”
를 계산합니다.
예시
“트로피가 너무 커서 가방에 들어가지 않았다.”
여기서 “너무 큰 것” 이
트로피인지 가방인지 문맥을 분석합니다.
핵심
Attention은 중요한 단어에 더 높은 가중치를 부여하여 문맥을 이해합니다.
⑥ Feed Forward Network (FFN)
의미를 더욱 풍부하게 학습합니다.
Attention으로 관계를 찾은 뒤
각 토큰은 작은 신경망(FFN)을 통과합니다.
이 과정에서
특징 추출
의미 강화
표현 고도화
가 이루어집니다.
핵심
Attention이 관계를 찾는다면,
FFN은 의미를 더욱 깊게 발전시키는 역할을 합니다.
⑦ Logits
다음 단어의 점수를 계산합니다.
AI는 여러 후보 단어를 평가하여
각 단어에 점수(Logit) 를 부여합니다.
예시
서울 5.1
부산 2.3
사과 -0.8
이 점수는
아직 확률이 아닌
선택 가능성을 나타내는 원시 점수(Raw Score) 입니다.
핵심
점수가 높을수록 다음 단어가 될 가능성이 커집니다.
⑧ Softmax
점수를 확률로 변환합니다.
Logit 점수는 Softmax 함수를 통해
확률로 변환됩니다.
예시
서울 92%
부산 7%
사과 1%
모든 확률의 합은
항상 100% 입니다.
핵심
AI는 점수가 아니라 확률을 기준으로 다음 단어를 선택합니다.
⑨ Sampling
어떤 단어를 최종 선택할까요?
확률이 계산되면 AI는
다음 토큰을 선택합니다.
이때 Temperature 설정이 매우 중요합니다.
낮은 Temperature
• 안정적
• 일관성 높음
• 사실 중심
높은 Temperature
• 창의적
• 다양한 표현
• 새로운 아이디어 생성
핵심
같은 질문이라도 Temperature 설정에 따라 답변이 달라질 수 있습니다.
⑩ Training vs Inference
학습과 추론은 다릅니다.
Training(학습)
다음 토큰 예측
오차(Loss) 계산
가중치 업데이트
Inference(추론)
질문 입력
학습된 가중치 사용
답변 생성
즉,
학습은 AI를 똑똑하게 만드는 과정이고,
추론은 배운 내용을 활용해 답변하는 과정입니다.
핵심 차이
* Training → AI가 배우는 과정
* Inference → AI가 실제로 답변하는 과정
한눈에 보는 LLM 동작 과정
입력 문장 → 토큰화 → 임베딩 → 위치 인코딩 → Transformer 블록 → Self-Attention → Feed Forward Network → Logits → Softmax → Sampling → 최종 답변 생성
이 10단계를 반복하면서 AI는 문맥을 이해하고, 가장 적절한 다음 단어를 예측하여 사람처럼 자연스러운 답변을 만들어냅니다.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)