
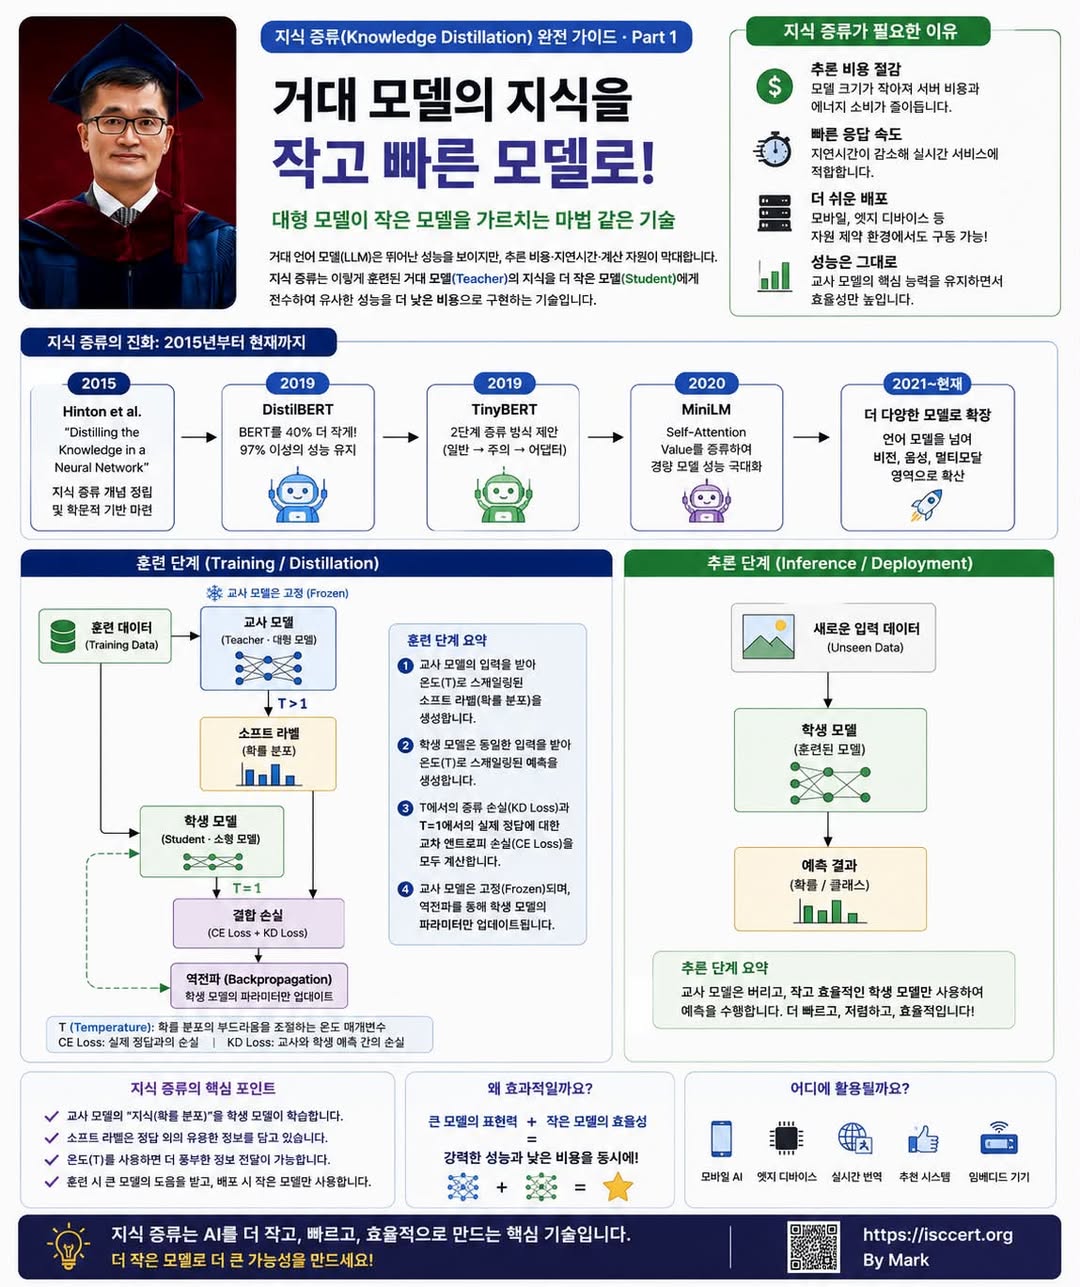
Knowledge Distillation(지식 증류), AI 경량화의 핵심 기술
ChatGPT, Claude, Gemini와 같은 초거대 AI 모델은 놀라운 성능을 제공하지만, 높은 GPU 비용과 느린 추론 속도, 막대한 전력 소비라는 한계를 가지고 있습니다.
그렇다면 거대한 모델의 성능은 유지하면서 더 작고 빠른 AI를 만들 수는 없을까요?
이 질문에 대한 가장 대표적인 해답이 바로 Knowledge Distillation(지식 증류) 입니다.
지식 증류는 큰 AI(Teacher Model)가 가진 지식을 작은 AI(Student Model)에게 효과적으로 전달하여, 성능은 최대한 유지하면서 비용과 속도를 크게 개선하는 AI 학습 기법입니다.
“큰 AI가 작은 AI를 가르친다.”
이것이 Knowledge Distillation의 핵심 개념입니다.
Knowledge Distillation이란?
Knowledge Distillation은 이미 학습을 완료한 대형 Teacher Model이 생성한 지식을 소형 Student Model이 학습하도록 하는 기술입니다.
학생 모델은 단순히 정답만 외우는 것이 아니라, 교사 모델이 어떤 이유와 확률로 답을 선택했는지까지 함께 학습합니다.
이러한 학습 덕분에 작은 모델도 대형 모델과 유사한 성능을 발휘할 수 있습니다.
Knowledge Distillation 동작 과정
① 대형 Teacher Model 학습 완료
먼저 수십억~수천억 개의 파라미터를 가진 대형 모델을 충분히 학습시킵니다.
이 모델은 이후 더 이상 학습되지 않고 고정(Frozen) 됩니다.
② Soft Label 생성
Teacher Model은 단순히 정답 하나만 출력하는 것이 아니라,
각 답변이 선택될 확률까지 포함한 Soft Label(확률 분포) 을 생성합니다.
예를 들어
정답
고양이 : 100%
이 아니라
고양이 : 88%
호랑이 : 9%
강아지 : 3%
처럼 AI가 생각하는 유사성과 관계성까지 함께 전달합니다.
③ Student Model 학습
Student Model은
실제 정답(Ground Truth)
Teacher가 만든 Soft Label
을 동시에 학습합니다.
따라서 작은 모델도 단순 암기가 아닌 추론 능력을 함께 습득하게 됩니다.
④ Student Model만 배포
학습이 끝나면
Teacher Model은 제거하고,
작고 빠른 Student Model만 실제 서비스에 사용합니다.
덕분에
빠른 응답
적은 GPU
낮은 비용
으로도 높은 성능을 제공합니다.
왜 Soft Label이 중요할까?
기존 AI 학습은
정답 = 1
오답 = 0
처럼 단순한 정답만 학습했습니다.
하지만 Soft Label은
“어떤 답이 얼마나 정답에 가까운가” 까지 알려줍니다.
즉,
AI가 단순히 외우는 것이 아니라
생각하는 방법까지 배우게 되는 것입니다.
Temperature(T)란?
Knowledge Distillation에서 자주 등장하는 개념이 Temperature(T) 입니다.
Temperature를 높이면
확률 분포가 더 부드러워져
Teacher Model이 가진 숨겨진 지식을 Student가 더 쉽게 학습할 수 있습니다.
즉,
Temperature는
AI가 지식을 얼마나 부드럽게 전달할 것인가를 조절하는 학습 도구라고 이해하면 됩니다.
Knowledge Distillation의 핵심 장점
추론 속도 향상
더 작은 모델을 사용하므로 응답 속도가 훨씬 빨라집니다.
운영 비용 절감
GPU 사용량과 서버 비용을 크게 줄일 수 있습니다.
모바일·엣지 AI 구현
스마트폰, 자동차, IoT 기기처럼 자원이 제한된 환경에서도 고성능 AI를 사용할 수 있습니다.
대규모 서비스 확장
동일한 서버 자원으로 더 많은 사용자를 처리할 수 있습니다.
에너지 효율 향상
전력 소비를 줄여 친환경 AI 구축에도 기여합니다.
대표적인 Knowledge Distillation 모델
DistilBERT (2019)
* BERT보다 약 40% 작은 크기
* 원본 성능의 약 97% 유지
TinyBERT (2019)
* Transformer 내부 지식까지 단계적으로 학습
* 모바일 환경에 최적화
MiniLM (2020)
* Attention과 Value 정보를 증류
* 작은 모델에서도 높은 성능 제공
최근에는 Llama, Qwen, Gemma, Mistral 등 다양한 오픈소스 LLM에도 Knowledge Distillation이 활발히 적용되고 있습니다.
어디에 활용될까?
Knowledge Distillation은 이미 다양한 산업에서 활용되고 있습니다.
스마트폰 AI
자율주행
AI Agent
챗봇
검색 엔진
번역 시스템
의료 AI
금융 AI
사이버 보안 AI
RAG 기반 기업 AI
핵심 정리
Knowledge Distillation은 큰 AI를 작은 AI로 단순히 축소하는 기술이 아닙니다.
대형 모델의 지식과 추론 능력을 효율적으로 전달하여, 작은 모델도 높은 성능을 유지하도록 만드는 핵심 AI 최적화 기술입니다.
AI 서비스가 대중화될수록 속도, 비용, 에너지 효율은 더욱 중요해질 것이며, Knowledge Distillation은 이를 해결하는 가장 핵심적인 기술 중 하나로 자리 잡고 있습니다.
“미래의 AI 경쟁력은 더 큰 모델을 만드는 것이 아니라, 더 작은 모델로도 최고의 성능을 구현하는 기술에서 결정됩니다.”
여러분은 AI 서비스에서 무엇이 더 중요하다고 생각하시나요?
① 최고의 성능 ② 빠른 응답 속도
③ 낮은 운영 비용 ④ 모바일·온디바이스 AI
여러분의 의견을 댓글로 함께 나눠보세요!
도움이 되셨다면 좋아요
저장하여 AI 학습 기술 참고자료로 활용하세요.
AI 개발자와 함께 공유해 보세요.
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)