
많은 사람들이 AI 성능을 이야기할 때 LLM, RAG, 벡터 데이터베이스(Vector DB), AI 에이전트에만 집중합니다.
하지만 실제 RAG(Retrieval-Augmented Generation) 프로젝트에서는 답변 품질을 가장 크게 좌우하는 요소가 따로 있습니다.
바로 Chunking(청킹) 입니다.
아무리 뛰어난 LLM을 사용하더라도 AI가 올바른 문맥(Context) 을 검색하지 못하면, 정확한 답변을 생성할 수 없습니다.
좋은 AI는 좋은 모델에서 시작하는 것이 아니라, 좋은 Chunk에서 시작됩니다.
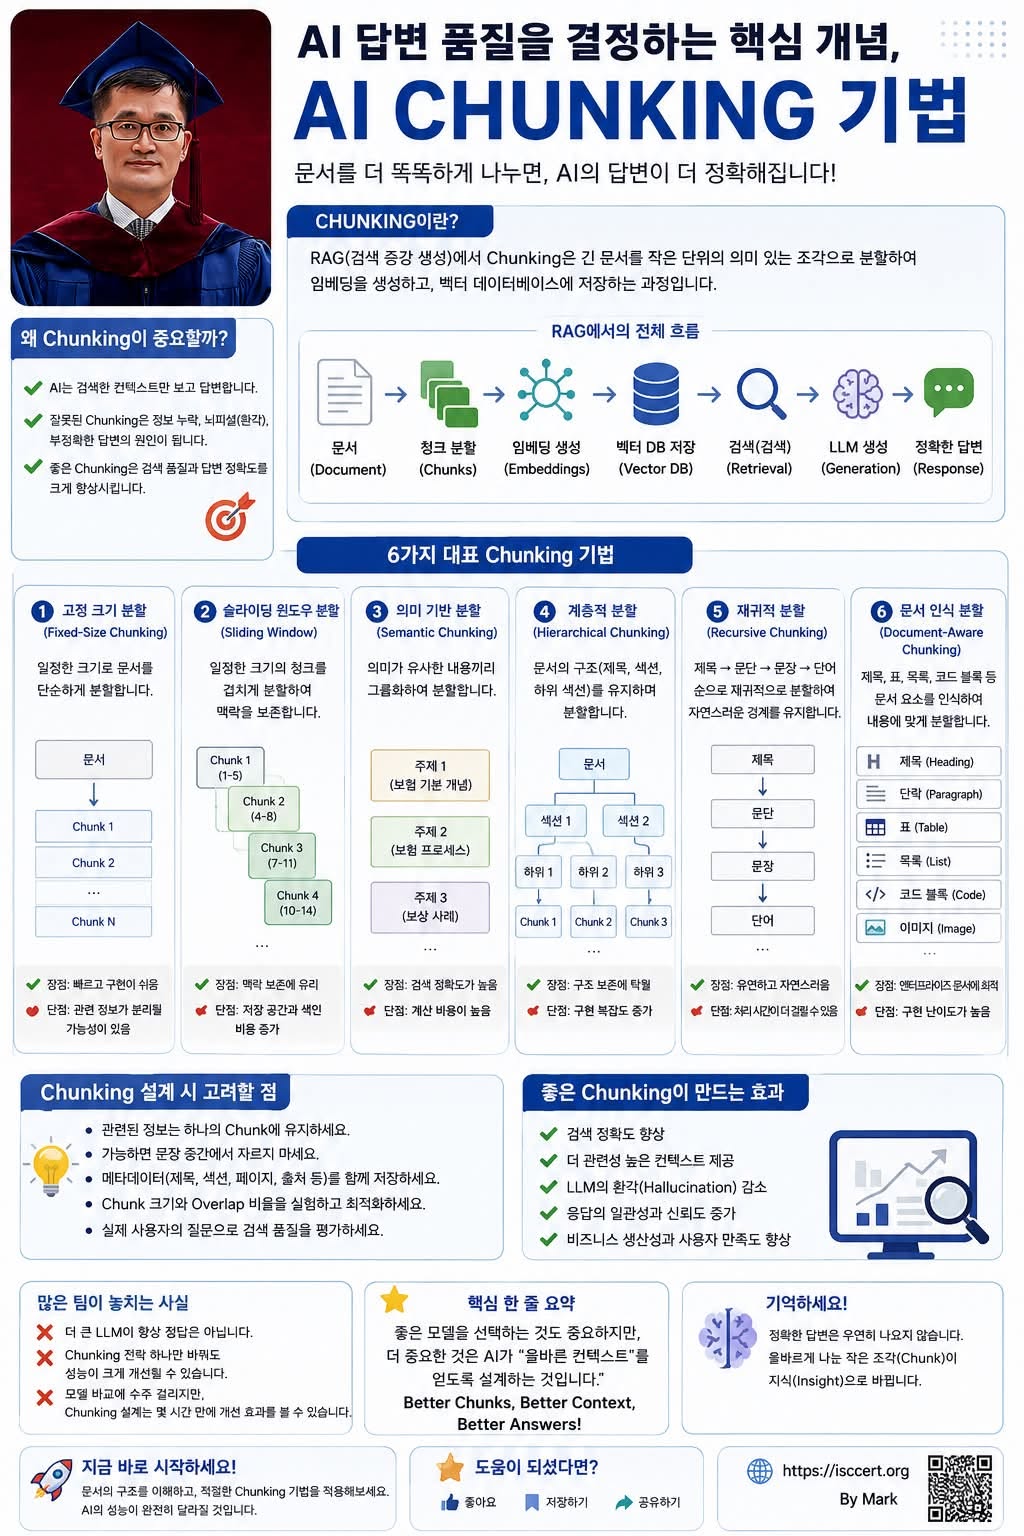
Chunking이란 무엇인가?
Chunking은 긴 문서를 의미 있는 작은 단위(Chunk) 로 나누어 임베딩(Embedding)을 생성하고, 벡터 데이터베이스(Vector DB)에 저장하는 과정입니다.
AI는 질문을 받으면 전체 문서를 읽는 것이 아니라, 가장 관련성이 높은 Chunk를 검색(Retrieval) 하여 답변을 생성합니다.
즉,
문서(Document)
Chunk 분할
임베딩(Embeddings)
Vector Database
검색(Retrieval)
LLM 추론
정확한 답변(Response)
대표적인 6가지 Chunking 기법
① Fixed-Size Chunking (고정 크기 분할)
문서를 일정한 길이(예: 500~1000토큰)로 나누는 가장 단순한 방법입니다.
장점
구현이 쉽고 빠름
단점
문장이나 문맥이 중간에서 끊길 수 있음
추천 환경
* 간단한 문서
* FAQ
* 프로토타입
② Sliding Window Chunking (슬라이딩 윈도우)
Chunk 일부를 다음 Chunk와 겹치도록 분할하여 문맥을 유지하는 방식입니다.
장점
문맥(Context) 보존
검색 정확도 향상
단점
저장 공간 증가
임베딩 비용 증가
추천 환경
* 긴 문서
* 기술 문서
* 계약서
③ Semantic Chunking (의미 기반 분할)
문장의 길이가 아니라 의미와 주제(Topic) 를 기준으로 문서를 분할합니다.
장점
가장 높은 검색 정확도
문맥 이해 향상
단점
계산 비용 증가
구현 난이도 높음
추천 환경
* AI 검색 서비스
* 기업 지식관리(Knowledge Base)
* 고객지원 시스템
④ Hierarchical Chunking (계층형 분할)
문서의 구조를 유지하면서 제목 → 장 → 절 → 문단 순으로 분할하는 방식입니다.
장점
문서 구조 유지
상위·하위 관계 표현
단점
설계가 다소 복잡함
추천 환경
* ISO 문서
* 정책 문서
* 기술 매뉴얼
* 연구 보고서
⑤ Recursive Chunking (재귀적 분할)
문서를 자연스러운 경계를 따라 단계적으로 분할합니다.
분할 순서
제목
문단
문장
단어
필요할 때만 더 작은 단위로 분할하므로 문맥 손실을 최소화할 수 있습니다.
추천 환경
* 다양한 형식의 문서
* 범용 RAG 시스템
⑥ Document-Aware Chunking (문서 인식 분할)
문서의 구조 요소를 인식하여 분할하는 가장 고도화된 방식입니다.
예를 들어
제목(Heading)
표(Table)
목록(List)
코드(Code Block)
이미지(Image)
등을 각각 독립적인 Chunk로 처리합니다.
장점
문서 구조 완벽 유지
검색 정확도 향상
Enterprise 문서에 최적
추천 환경
* 기업 문서
* 법률 문서
* ISO 표준
* 개발 문서
* 매뉴얼
좋은 Chunking을 위한 5가지 실무 원칙
관련된 내용은 하나의 Chunk에 함께 저장하세요.
문장 중간에서 잘라 문맥을 훼손하지 마세요.
제목, 페이지, 문서명 등 메타데이터를 함께 저장하세요.
Chunk 크기와 Overlap 비율을 실제 데이터로 반복 검증하세요.
실제 사용자 질문으로 검색 품질(Retrieval Quality)을 지속적으로 평가하세요.
많은 팀이 놓치는 사실
더 큰 LLM이 항상 더 좋은 답을 만드는 것은 아닙니다.
벡터 데이터베이스만 바꾼다고 성능이 크게 향상되지는 않습니다.
프롬프트만 수정해서는 근본적인 문제가 해결되지 않습니다.
실제로는 Chunking 전략 하나만 개선해도 검색 정확도와 답변 품질이 크게 향상되는 경우가 많습니다.
RAG 성능을 높이는 핵심 공식
좋은 문서 구조
➜ 좋은 Chunking
➜ 정확한 Embedding
➜ 높은 검색 정확도(Retrieval)
➜ LLM의 정확한 추론
➜ 신뢰할 수 있는 AI 답변
핵심 정리
RAG 시스템의 성능은 LLM의 크기보다 얼마나 좋은 문맥(Context)을 제공하느냐에 달려 있습니다.
Chunking은 단순히 문서를 자르는 작업이 아니라, AI가 올바른 정보를 검색하고 이해하도록 설계하는 핵심 아키텍처 기술입니다.
특히 기업용 AI, ISO 문서 검색, 기술 문서, 법률 문서, 고객지원 시스템과 같은 고품질 RAG에서는 Semantic Chunking, Hierarchical Chunking, Document-Aware Chunking이 뛰어난 성능을 제공합니다.
“좋은 AI는 더 큰 모델이 아니라, 더 좋은 Context에서 탄생합니다.
Better Chunks → Better Context → Better Retrieval → Better Answers.”
여러분의 RAG 프로젝트에서는 어떤 Chunking 전략을 사용하고 계신가요?
도움이 되셨다면 좋아요
저장하여 RAG 설계 가이드로 활용하세요.
AI 개발자와 함께 공유해 보세요!
— 이춘곤(Mark) · ISC.studio · ISC출판 도서 안내
이 글은 저자의 Facebook에 처음 게시한 글입니다. Facebook 원문 보기

💬 댓글 (0)