<AI 공룡과 싸우는 방법: 한국이 나아갈 길>
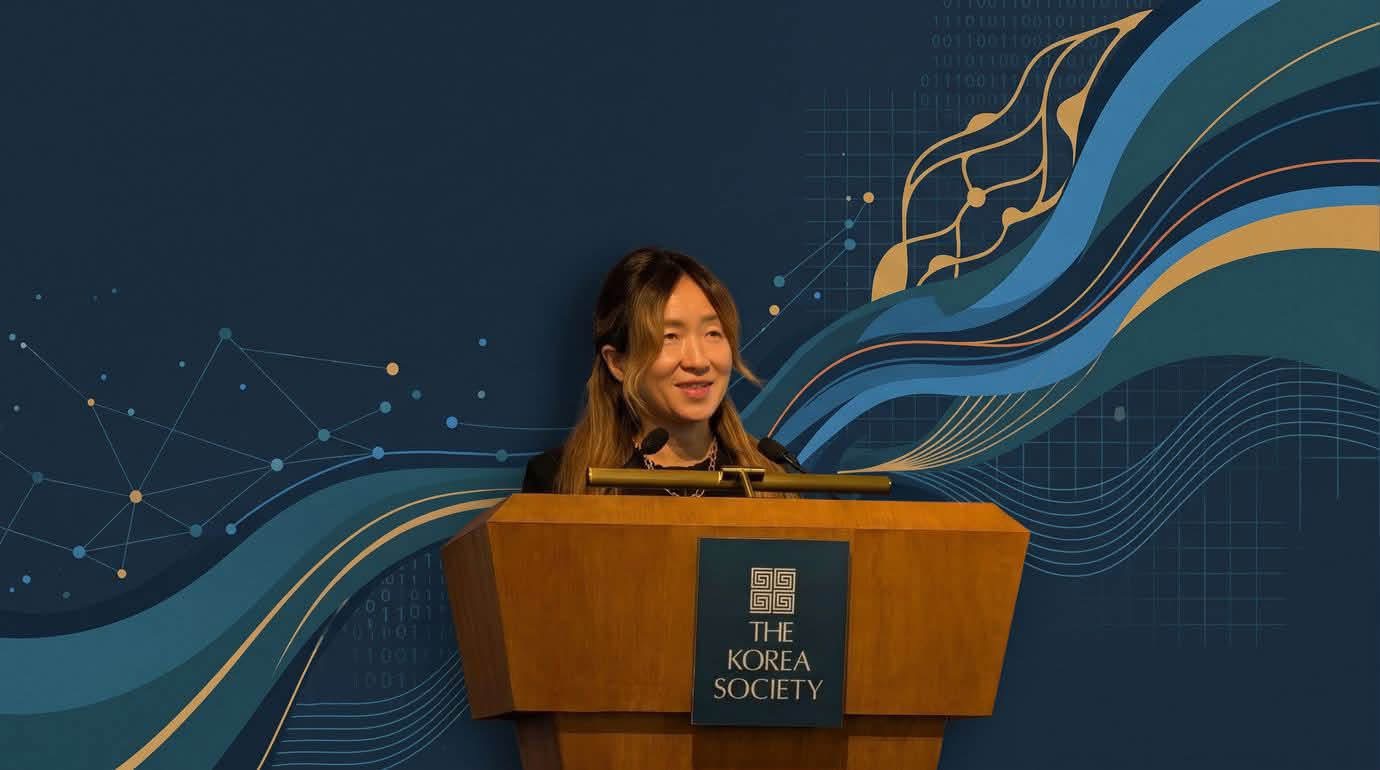
1. 최근 뉴욕 맨해튼에서 AI 석학 최예진 교수님을 만남
2. 스탠퍼드 HAI 선임 펠로이자 2023년, 2025년 타임 ‘AI 100인’에 선정된 최고 전문가답게 놀라운 인사이트를 제시
3. AI 업계의 오랜 통념인 스케일링의 법칙에 정면으로 물음표를 던진 것
4. 출발점은 2023년 샘 알트만 오픈AI(OpenAI) CEO의 발언. 당시 인도 스타트업이 파운데이션 모델을 만들 수 있냐고 질문하자 알트만은 ”시도하지 말라“는 취지로 답함
5. 적은 예산으로 오픈AI 같은 프런티어 AI랩과 경쟁하는 건 불가능하다는 것. ‘막대한 자본과 컴퓨팅 자원(GPU)이 곧 성능’이라는 믿음의 표출이었음
6. 하지만 그 믿음에 균열이 생기는 중. 일리야 수츠케버가 2024년 뉴립스 수상 강연에서 “우리가 아는 사전학습은 끝날 것”이라고 선언한 것이 시작. 지금까지의 방법이 통하지 않게 된다는 것
7. 컴퓨트만 늘리는 무차별 스케일링(brute-force scaling)의 시대는 끝났다는 진단. 그러면 어떻게 더 나은 AI를 만들까. 최 교수님은 ‘스마트 스케일링’이 필요하다고 주장
8. 방법은 크게 세 가지. ①적은 데이터로 더 빠르고 잘 배우도록 만들기 ②바깥 영역에서 새로운 데이터 합성하기 ③배포 시점에도 계속 배우는 테스트타임 스케일링 활용 등
9. 최 교수님이 엔비디(NVIDIA)아 연구진과 함께 발표한 ProRL 훈련법이 대표적. 이렇게 만든 15억(1.5B) 매개변수 모델은 딥시크-R1 7B(70억) 모델과 대등하거나 능가한 결과를 냄. 작은 모델이 성능에서 큰 모델을 앞선 것
10. 데이터의 '다양성'으로 벤치마크 성능을 높이는 '프리즘 합성'도 부상. 이 방식으로 20배 적은 데이터로 훈련한 모델이 20배 큰 데이터의 모델들을 수학 벤치마크에서 앞지름
7. 'TTT-디스커버'는 추론 시점에도 강화학습을 이어가는 방식. 오픈AI의 오픈웨이트 모델 gpt-oss-120b로 수학·GPU 커널·알고리즘·생물학 문제에서 최고 기록을 갈아치웠는데, 문제당 비용은 수백 달러 수준에 불과했던 사례
8. 이런 흐름은 딥시크의 놀라운 성과에서도 확인됨. Artificial Analysis 지능 지수(v4.3.2)에서 딥시크의 오픈웨이트 모델은 지능 지수 45를 기록하면서도 작업당 비용은 0.25달러 수준으로 프런티어 모델들의 수십 분의 1 비용. ‘작은데 더 좋은(smaller yet better)’ 모델이 실제로 나오고 있음
9. 최 교수님의 메시지가 한국에 더 중요한 이유. 컴퓨팅 자원과 자본이 상대적으로 부족한 환경에서 활용할 수 있는 명확한 방향성을 제시하기 때문. 어떤 데이터를 어떻게 설계할지, 더 효율적이고 똑똑한 학습 방식 등을 더 고민하고 방법을 찾아야
10. HBR에 소개된 논문 "Why Constraints Are Good for Innovation"과도 같은 발상의 전환이 필요한 것. 제한된 상황이 오히려 창의성을 강화할 수 있음. 부족한 자원은 핸디캡이 아니라 다른 길을 찾게 만드는 조건
더밀크 The Miilk
💬 댓글 (0)